Régression ridge
Séance 5 — Pénaliser pour mieux prédire
Christophe Ambroise 
UEVE, UMR CNRS 8071
12 octobre 2026
Régression
Classification vs régression
Classification
\(Y\) à valeurs finies, coût 0-1, règle optimale \(\arg\max P(Y \mid X)\).
. . .
Régression
\(Y\) continue : coût quadratique, règle optimale :
\[ f^*(x) = \mathbb E[Y \mid X = x]. \]
Le modèle linéaire
\[ \mathbf y = \mathbf X \boldsymbol\beta + \boldsymbol\varepsilon, \qquad \boldsymbol\varepsilon \sim \mathcal N(0, \sigma^2 \mathbf I_n). \]
Moindres carrés : critère et solution.
\[ \widehat{\boldsymbol\beta}_{\mathrm{MCO}} = \arg\min_{\boldsymbol\beta} \|\mathbf y - \mathbf X\boldsymbol\beta\|^2 = (\mathbf X^\top \mathbf X)^{-1} \mathbf X^\top \mathbf y . \]
Jeu de données exemple : diabetes de scikit-learn
Jeu diabète : 442 patients, 10 variables, progression de la maladie à un an.
age, sex, bmi, bp |
données cliniques |
s1 … s6 |
six dosages sanguins |
Variables centrées-réduites ; réponse continue, moyenne 152, écart-type 77.
Limites des moindres carrés
La variance de l’estimateur
\[ \operatorname{Var}(\widehat{\boldsymbol\beta}_{\mathrm{MCO}}) = \sigma^2 (\mathbf X^\top \mathbf X)^{-1} \]
Diagonalisation \(\mathbf X^\top \mathbf X = \sum_i d_i^2\, v_i v_i^\top\) :
\[ \operatorname{Var}\big(v_i^\top \widehat{\boldsymbol\beta}\big) = \frac{\sigma^2}{d_i^2} . \]
Conditionnement \(\kappa = (d_{\max}/d_{\min})^2\) : sur le diabète, \(\kappa = 470\).
Prédiction en \(\mathbf x\) : variance \(\sigma^2 \sum_i (\mathbf x^\top v_i)^2 / d_i^2\).
Une valeur singulière proche de zéro : variance explosive dans une direction — prédiction instable.
Trois configurations
- Colinéarité : deux variables, presque la même mesure.
- \(p\) proche de \(n\) : trop peu d’observations par paramètre.
- \(p > n\) : \(\mathbf X^\top \mathbf X\) non inversible ; \(\widehat{\boldsymbol\beta}_{\mathrm{MCO}}\) inexistant.
Troisième cas : la norme en génomique, imagerie, traitement du signal.
Sur le diabète
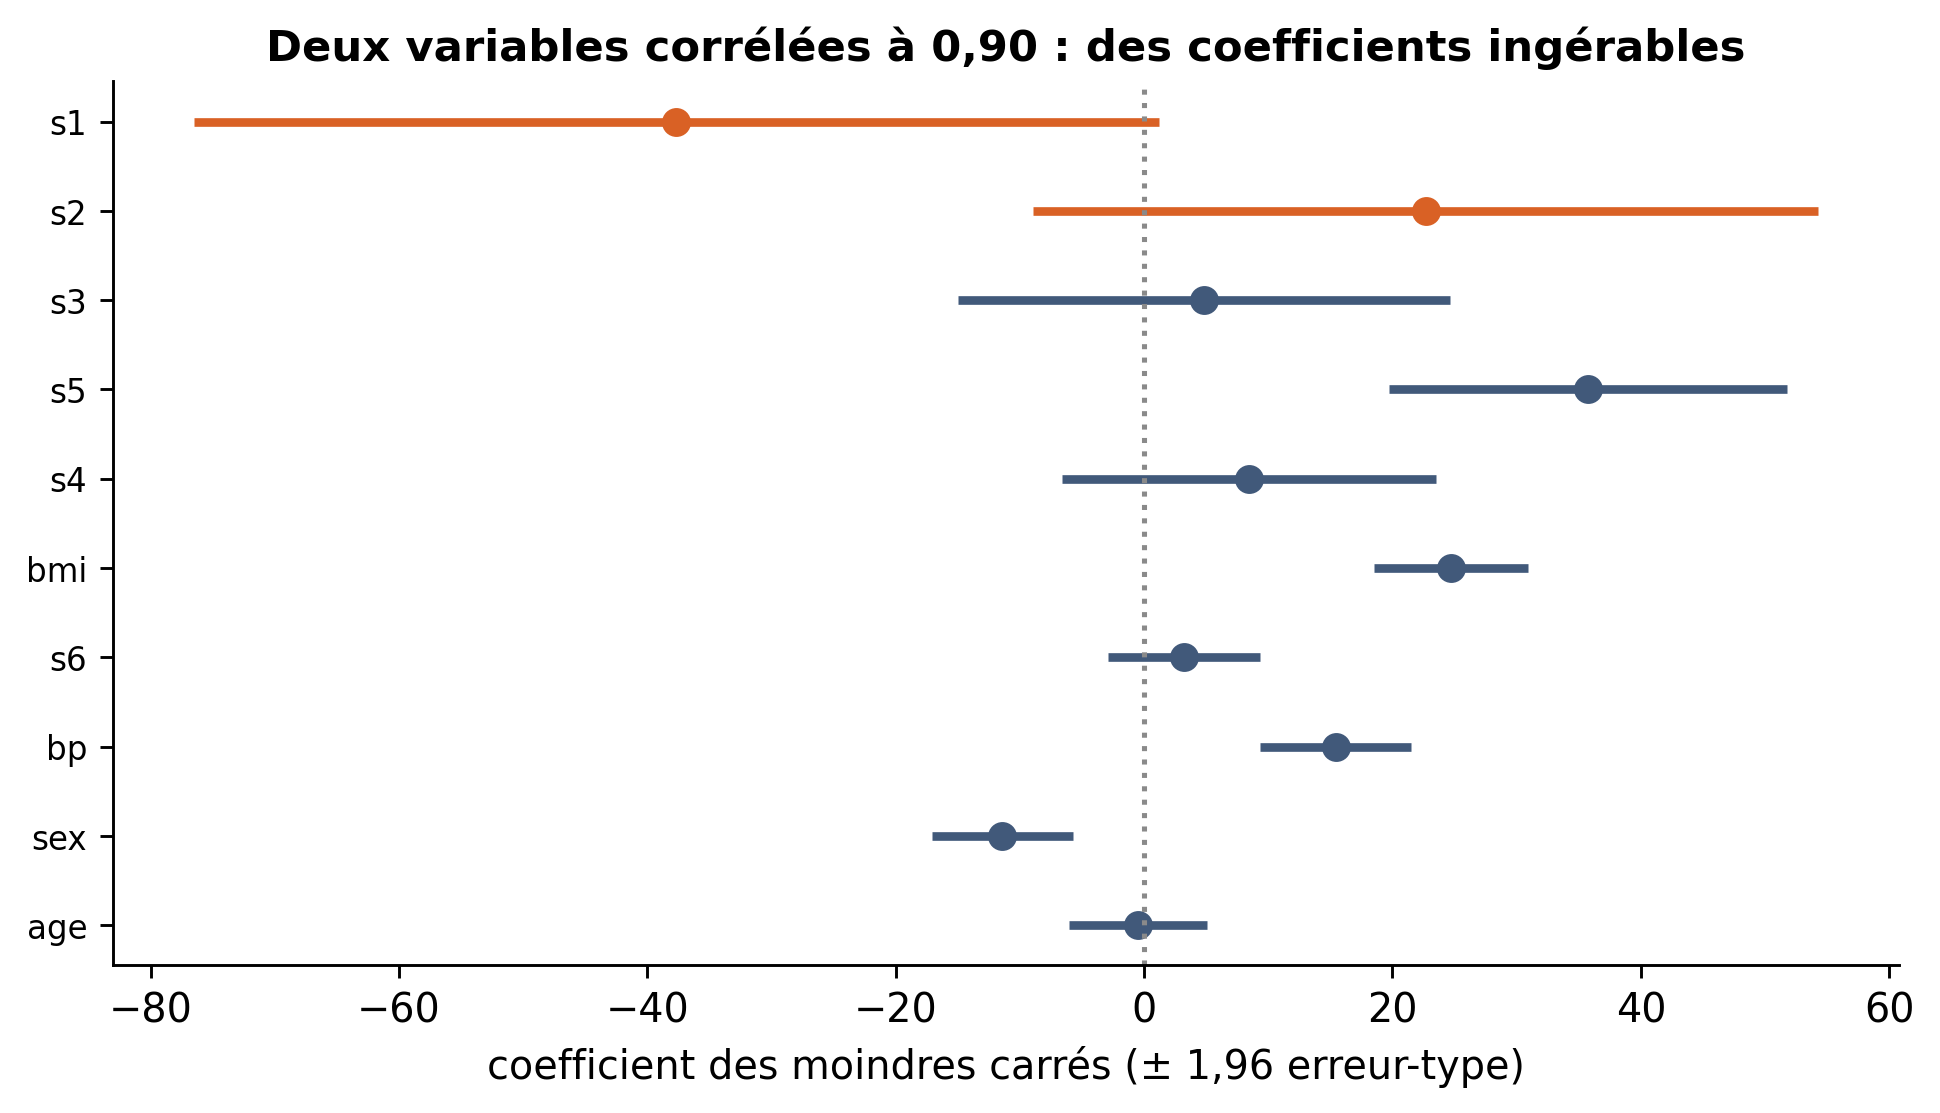
Six dosages sanguins fortement liés : s1, s2 corrélés à 0,90.
Lecture de la figure
Coefficients : s1 à \(-37{,}7\), s2 à \(+22{,}7\) ; erreurs-types 19,8 et 16,1.
Ni l’un ni l’autre significatif (\(|t| < 2\)) ; bmi largement significatif (\(t = 7{,}8\)), coefficient plus petit.
Deux gros coefficients de signes opposés, presque annulés ; le modèle compense l’un par l’autre. Signe non déterminé par les données.
Retour sur la stratégie de régularisation
\[ f^* = \arg\min_{f \in \mathcal F} \; \widehat R(f, D_n) + H(f) \]
\(\mathcal F\) non restreint ; complexité rendue coûteuse.
Ridge : réalisation de la stratégie de régularisation pour le modèle linéaire. Autre réalisation en classification : élagage des arbres.
La régression ridge
Le critère
\[ \widehat{\boldsymbol\beta}_\lambda = \arg\min_{\boldsymbol\beta} \Big\{ \|\mathbf y - \mathbf X\boldsymbol\beta\|^2 + \lambda \|\boldsymbol\beta\|^2 \Big\}, \qquad \lambda \geq 0 . \]
Un terme ajouté : norme au carré des coefficients. Un hyperparamètre : \(\lambda\).
La solution
Gradient annulé :
\[ -2\mathbf X^\top(\mathbf y - \mathbf X\boldsymbol\beta) + 2\lambda\boldsymbol\beta = 0 \;\Longleftrightarrow\; (\mathbf X^\top\mathbf X + \lambda \mathbf I)\boldsymbol\beta = \mathbf X^\top \mathbf y . \]
\[ \widehat{\boldsymbol\beta}_\lambda = (\mathbf X^\top \mathbf X + \lambda \mathbf I_p)^{-1} \mathbf X^\top \mathbf y . \]
Différence unique avec les moindres carrés : arête ajoutée à la diagonale. D’où le nom.
Toujours inversible
Pour tout \(\lambda > 0\) et toute matrice \(\mathbf X\), la matrice \(\mathbf X^\top \mathbf X + \lambda \mathbf I\) est définie positive, donc inversible.
Preuve. \(\mathbf X^\top\mathbf X\) est semi-définie positive, de valeurs propres \(d_i^2 \geq 0\). Celles de \(\mathbf X^\top\mathbf X + \lambda\mathbf I\) valent \(d_i^2 + \lambda > 0\). \(\square\)
Solution ridge même pour \(p > n\), là où les moindres carrés n’en ont aucune. Non un raffinement : un changement de domaine d’existence.
L’intercept ne se pénalise pas
\[ \min_{\beta_0, \boldsymbol\beta} \|\mathbf y - \beta_0 \mathbf 1_n - \mathbf X\boldsymbol\beta\|^2 + \lambda \|\boldsymbol\beta\|^2 \]
\(\mathbf X\) centrée : solution séparée.
\[ \widehat\beta_0 = \bar y, \qquad \widehat{\boldsymbol\beta}_\lambda = (\mathbf X^\top\mathbf X + \lambda\mathbf I)^{-1}\mathbf X^\top \tilde{\mathbf y}, \quad \tilde{\mathbf y} = \mathbf y - \bar y \mathbf 1_n . \]
Pénaliser \(\beta_0\) : prédiction dépendante de l’origine de \(y\). \(\beta_0\) toujours exclu.
Échelle des variables
Pénalité \(\|\boldsymbol\beta\|^2\) : même traitement de toutes les coordonnées.
Centimètres → mètres : coefficient multiplié par 100, pénalité par 10 000.
Ridge : sens sur variables standardisées seulement. Même règle qu’en séance 3 pour les \(k\)-PPV, raison différente : là la distance, ici la pénalité.
Les deux extrémités
\(\lambda \to 0\)
\(\widehat{\boldsymbol\beta}_\lambda \to \widehat{\boldsymbol\beta}_{\mathrm{MCO}}\)
Aucune contrainte.
\(\lambda \to \infty\)
\(\widehat{\boldsymbol\beta}_\lambda \to \mathbf 0\)
Le modèle prédit \(\bar y\) partout.
Entre les deux, un continuum de modèles : le \(k\) des voisins, le \(\alpha\) des arbres, autre habit.
Le chemin de régularisation
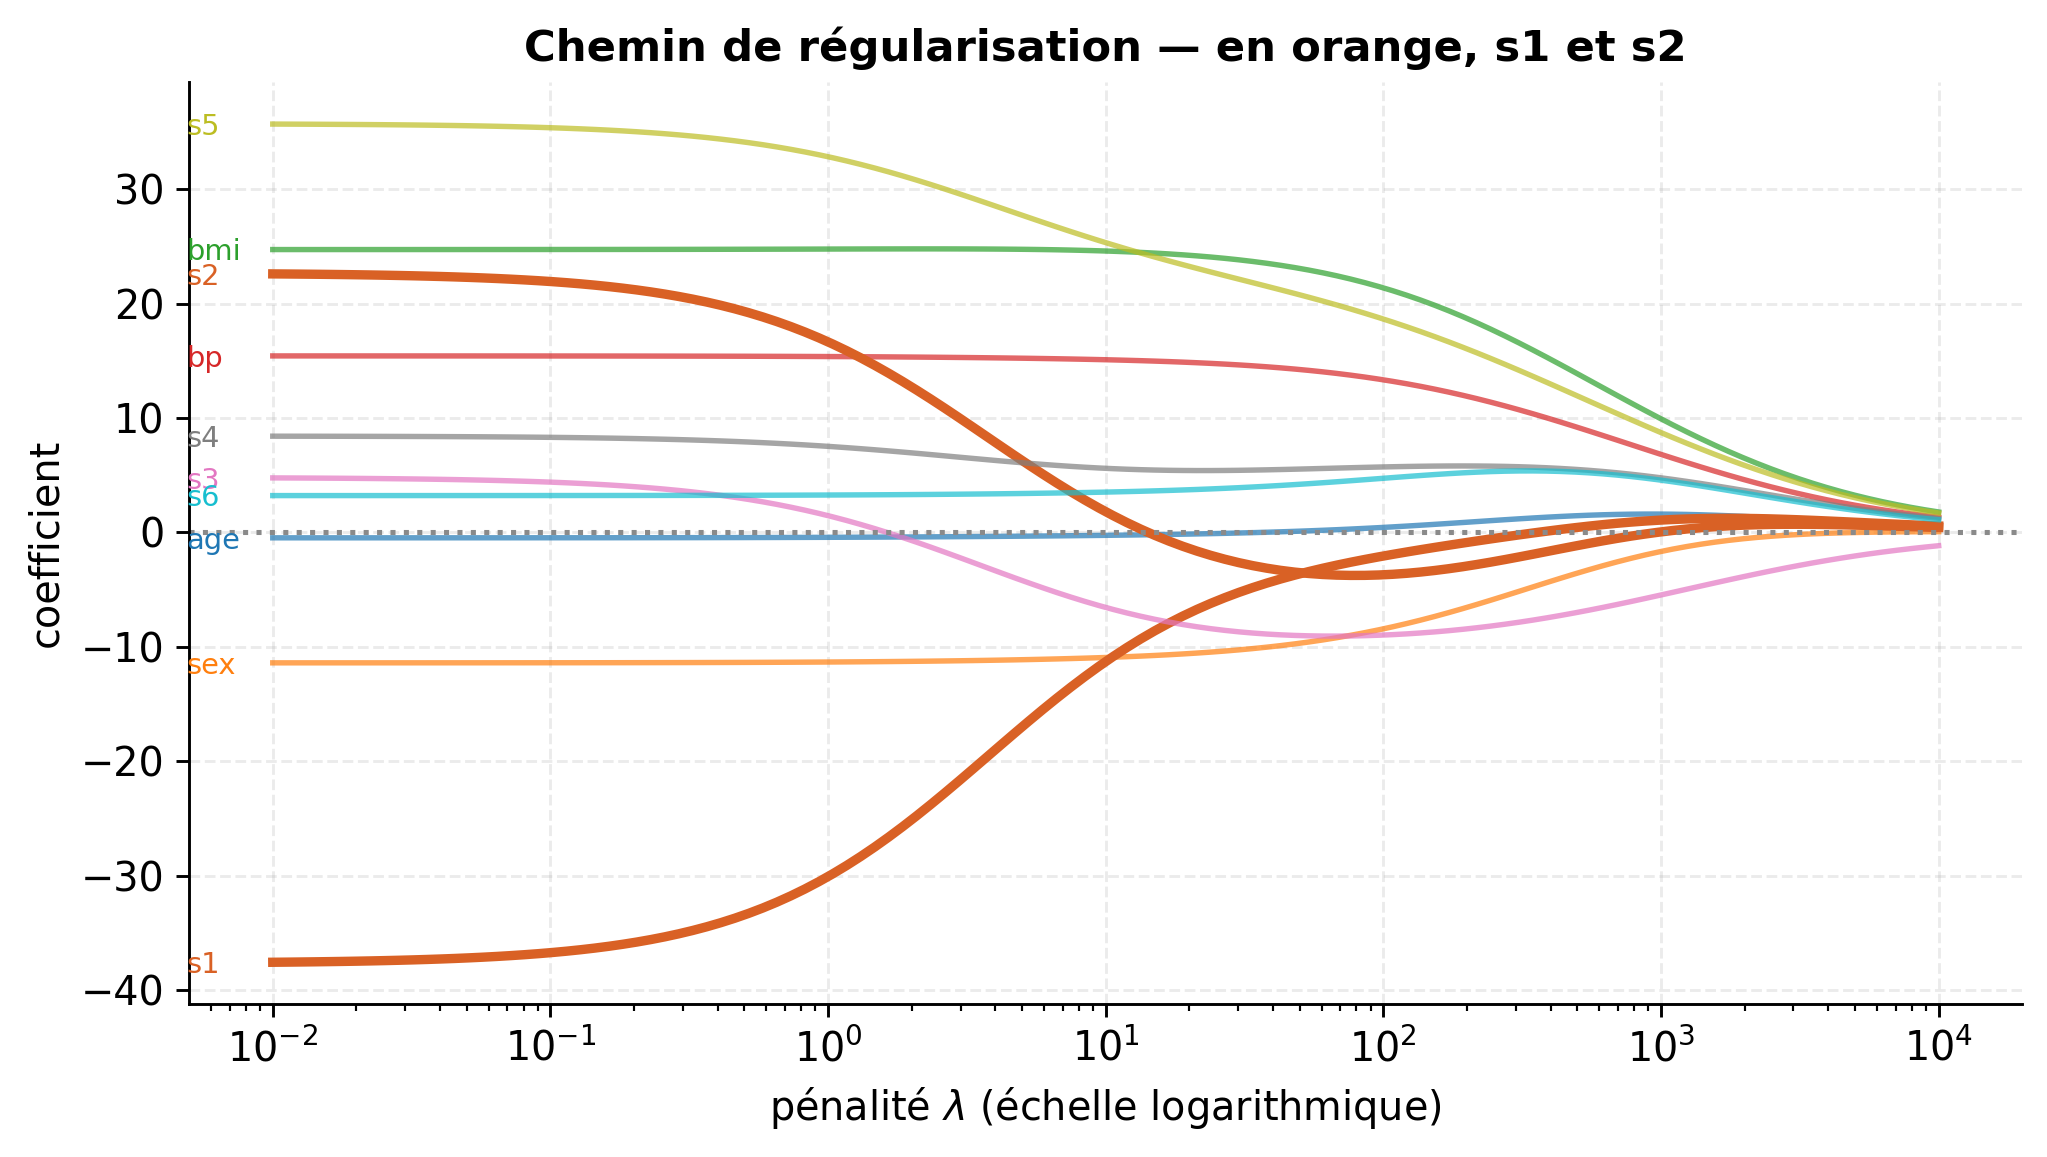
À gauche, s1 à \(-38\), s2 à \(+23\) ; dès \(\lambda \approx 10\), retour près de zéro, bmi presque inchangé. Ridge : cible prioritaire, les coefficients non déterminés par les données.
La forme contrainte
Problème pénalisé \(\equiv\) problème sous contrainte :
\[ \min_{\boldsymbol\beta} \|\mathbf y - \mathbf X\boldsymbol\beta\|^2 \quad \text{sous} \quad \|\boldsymbol\beta\|^2 \leq t , \]
correspondance décroissante \(\lambda \leftrightarrow t\).
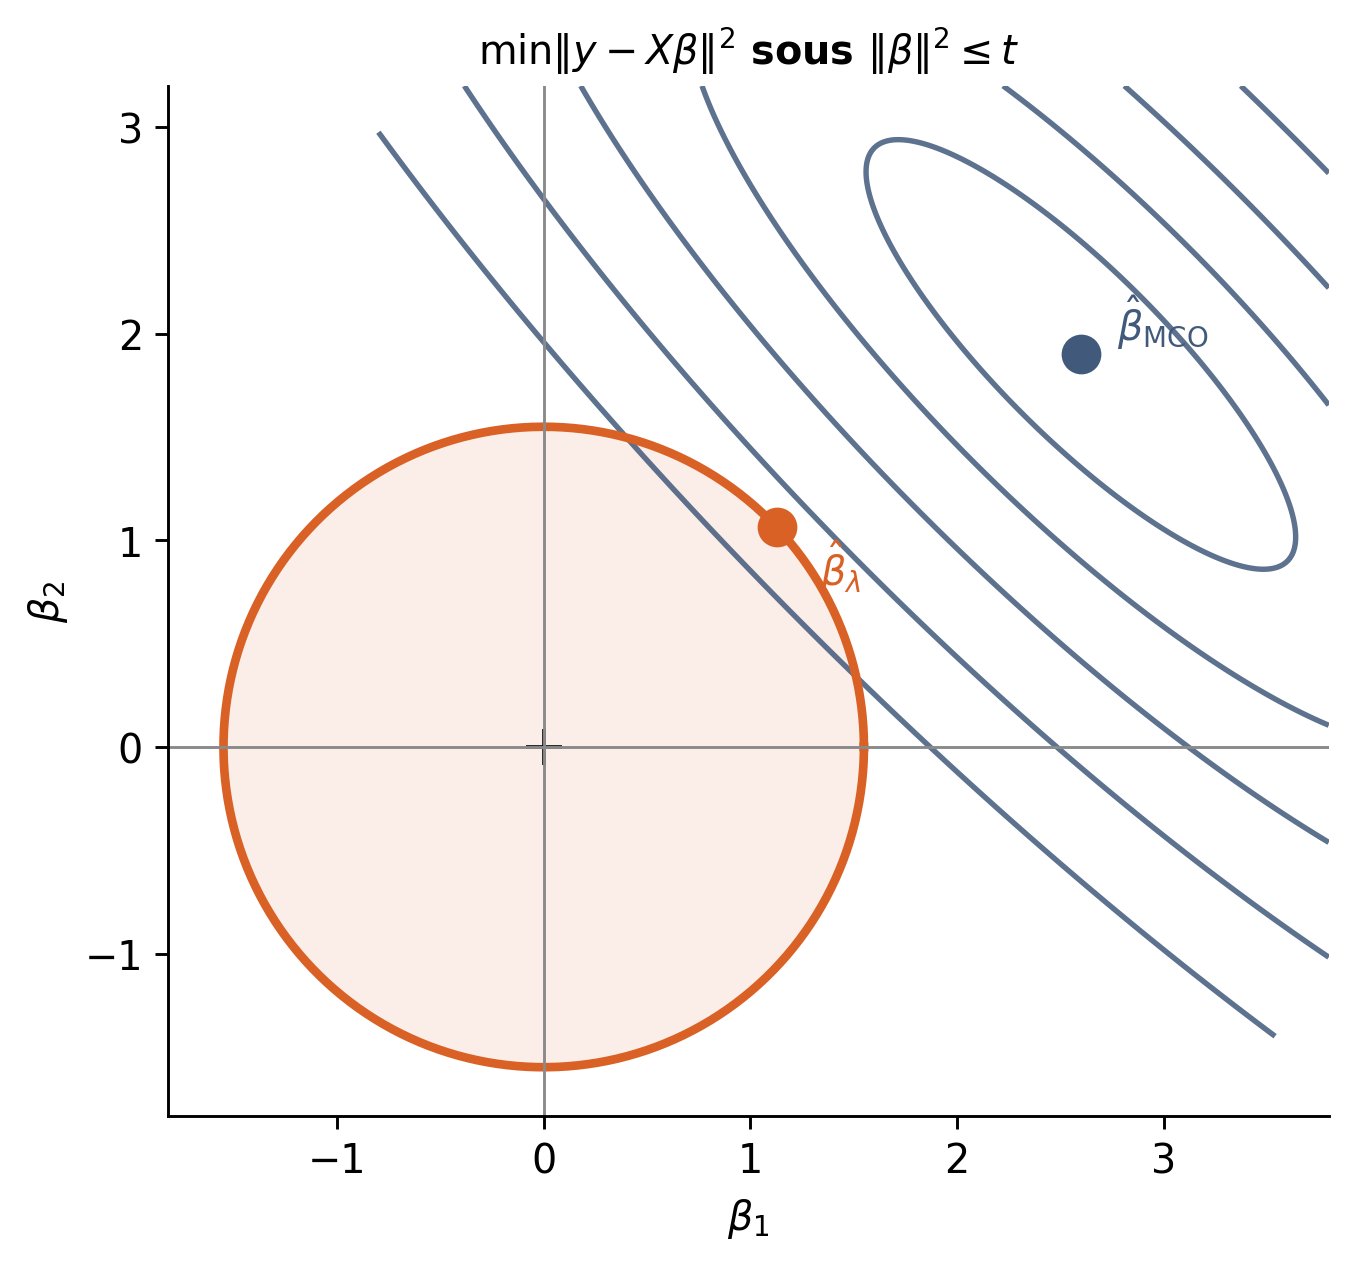
Ellipses : lignes de niveau du coût. Disque : contrainte. Solution : point du disque touché par la plus petite ellipse — disque rond, deux coordonnées non nulles. À retenir : le losange du lasso, conclusion opposée.
Ce que dit la théorie
Biais et variance, explicitement
Notation : \(\mathbf W_\lambda = (\mathbf X^\top\mathbf X + \lambda\mathbf I)^{-1}\).
\[ \begin{aligned} \operatorname{Biais}(\widehat{\boldsymbol\beta}_\lambda) &= -\lambda\, \mathbf W_\lambda\, \boldsymbol\beta, \\ \operatorname{Var}(\widehat{\boldsymbol\beta}_\lambda) &= \sigma^2\, \mathbf W_\lambda \mathbf X^\top\mathbf X\, \mathbf W_\lambda . \end{aligned} \]
Biais nul en \(\lambda = 0\), croissant avec \(\lambda\). Variance totale \(\sum_j \operatorname{Var}(\widehat\beta_j)\) décroissante.
Deux monotonies opposées : compromis forcé. Biais faible, variance forte → \(\lambda\) petit. Biais fort, variance faible → \(\lambda\) grand.
Le cas orthogonal
Hypothèse \(\mathbf X^\top \mathbf X = n\,\mathbf I_p\) :
\[ \widehat{\boldsymbol\beta}_\lambda = \frac{1}{n + \lambda}\mathbf X^\top \mathbf y = \frac{n}{n+\lambda}\, \widehat{\boldsymbol\beta}_{\mathrm{MCO}} . \]
Chaque coefficient multiplié par un facteur \(< 1\) : contraction à l’état pur.
La MSE, en fermé
Avec \(\mathrm{MSE}(\widehat\beta) = \frac1n \mathbb E\|\mathbf X\widehat\beta - \mathbf X\boldsymbol\beta\|^2\) :
\[ \mathrm{MSE}(\widehat{\boldsymbol\beta}_\lambda) = \underbrace{\frac{\lambda^2\,\|\boldsymbol\beta\|^2}{(n+\lambda)^2}}_{\text{biais}^2} + \underbrace{\frac{n\,p\,\sigma^2}{(n+\lambda)^2}}_{\text{variance}} . \]
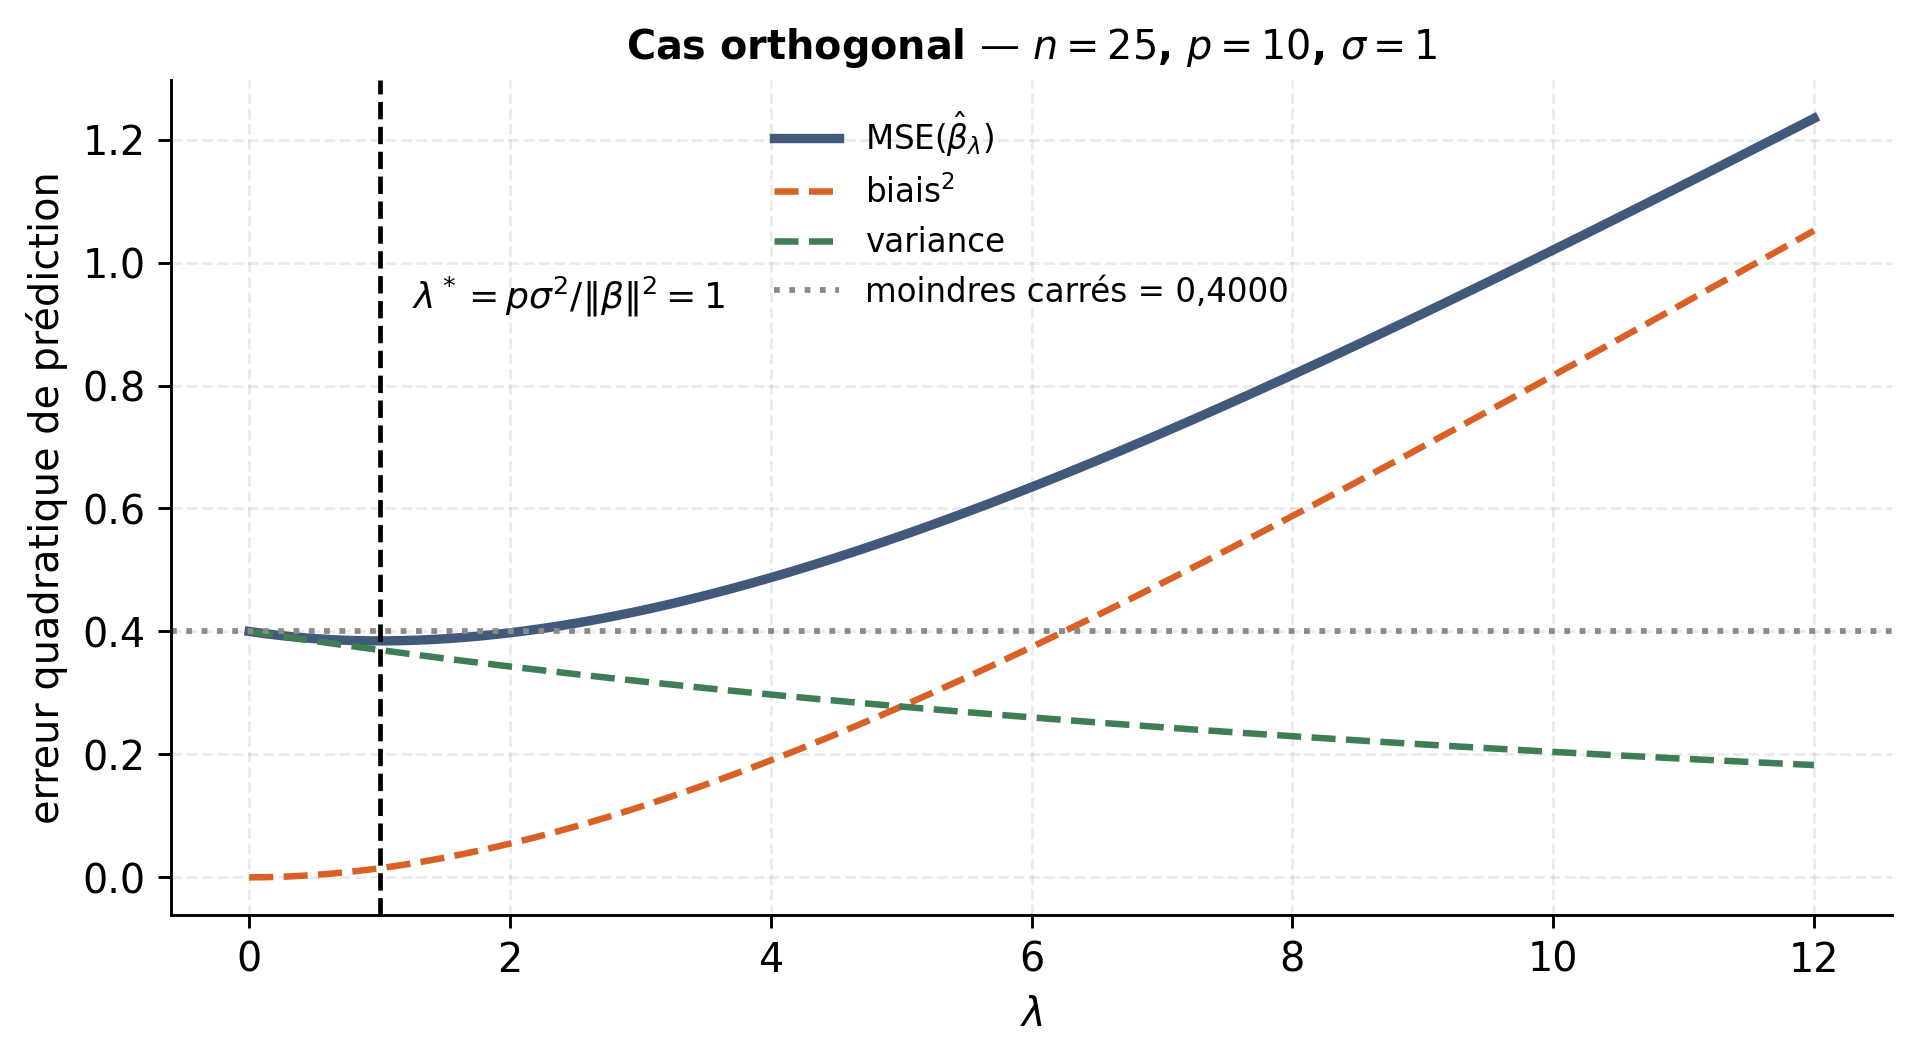
\(\lambda\) de \(0\) à \(\infty\) : biais² de \(0\) à \(\|\boldsymbol\beta\|^2\), variance de \(p\sigma^2/n\) (moindres carrés) à \(0\).
Le \(\lambda\) optimal
Dérivée annulée :
\[ \lambda^* = \frac{p\,\sigma^2}{\sum_{j=1}^p \beta_j^2} = \frac{p\,\sigma^2}{\|\boldsymbol\beta\|^2} . \]
Strictement positif pour \(\boldsymbol\beta \neq \mathbf 0\).
Croissant avec le bruit et le nombre de variables, décroissant avec la force du signal. Chaque terme à sa place.
La MSE, en image
Le théorème d’existence
Théorème
Pour tout \(\boldsymbol\beta \neq \mathbf 0\), il existe \(\lambda^* > 0\) tel que
\[ \mathrm{MSE}(\widehat{\boldsymbol\beta}_{\lambda^*}) < \mathrm{MSE}(\widehat{\boldsymbol\beta}_{\mathrm{MCO}}) . \]
Idée. \(M(\lambda) = \mathrm{MSE}(\widehat{\boldsymbol\beta}_\lambda)\) dérivable, \(M'(0) < 0\) : variance décroissante d’ordre \(\lambda\), biais croissant d’ordre \(\lambda^2\). Biais incapable de rattraper la variance près de zéro.
Portée du théorème
Modèle linéaire exactement vrai, bruit exactement gaussien : l’estimateur non biaisé n’est pas le meilleur.
Un peu de biais volontaire : gain de variance supérieur au coût — au moins au départ.
Contre-intuitif : fondement de toute la régularisation moderne.
Limites du théorème
- Quel \(\lambda\) ? \(\lambda^*\) dépend de \(\boldsymbol\beta\) et \(\sigma\), tous deux inconnus.
- Tout \(\lambda > 0\) : aucune garantie d’amélioration.
- Taille du gain : parfois négligeable.
Théorème d’existence : garantit quelque chose à chercher, ne le trouve pas.
Ridge par la SVD
Une seule factorisation
Cent valeurs de \(\lambda\) : cent inversions \(p \times p\). La SVD évite tout :
\[ \mathbf X = \mathbf U \mathbf D \mathbf V^\top, \qquad \mathbf D = \operatorname{diag}(d_1, \dots, d_p). \]
\[ \widehat{\boldsymbol\beta}_\lambda = \mathbf V \operatorname{diag}\!\left(\frac{d_i}{d_i^2 + \lambda}\right) \mathbf U^\top \tilde{\mathbf y} . \]
Ridge est un filtre
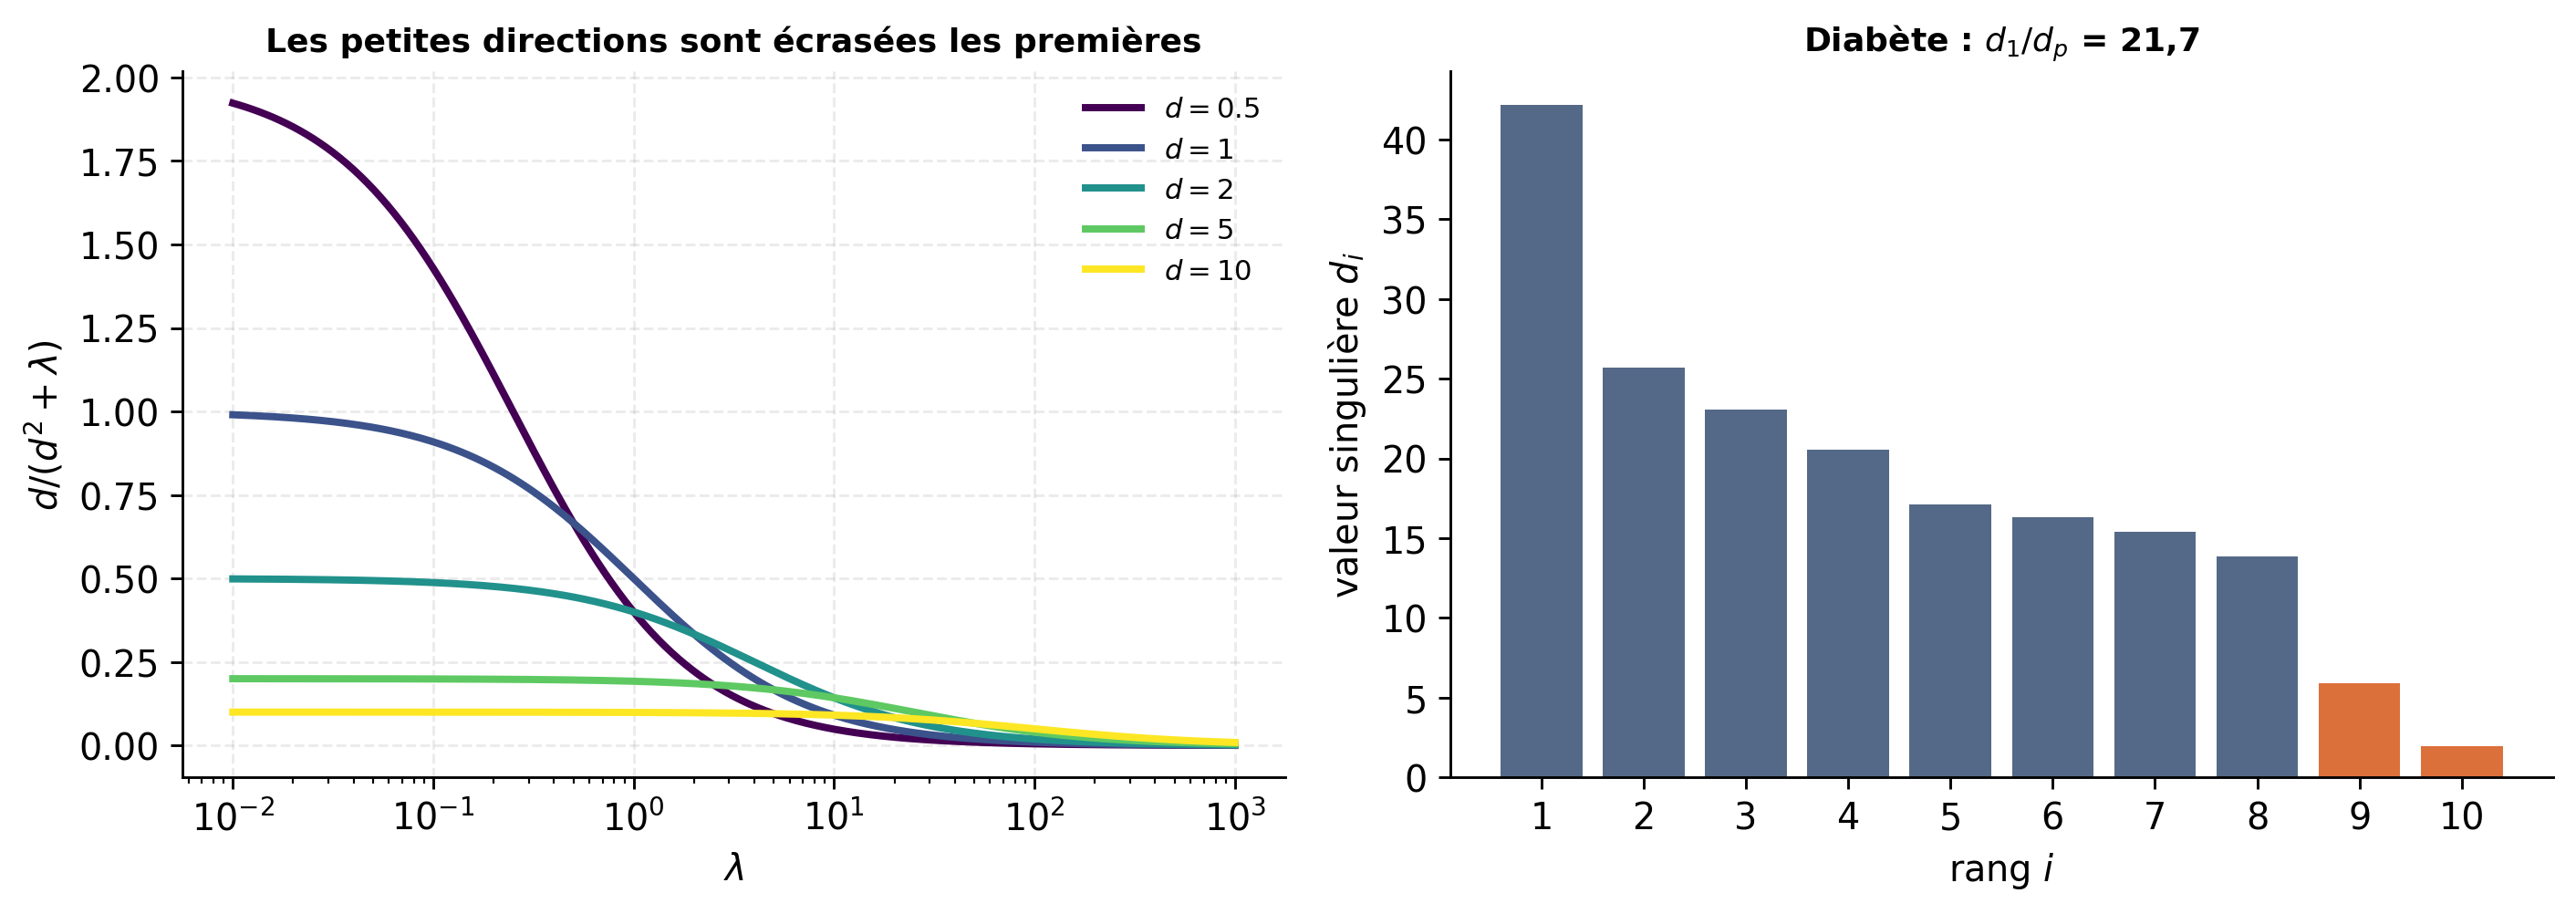
Base des directions principales : chaque coordonnée séparée, multipliée par
\[ \frac{d_i}{d_i^2 + \lambda} \qquad\text{au lieu de}\qquad \frac{1}{d_i} \;\;\text{(moindres carrés)} . \]
\(d_i\) grand : facteur proche de \(1/d_i\), direction intacte.
\(d_i\) petit : \(1/d_i\) explosif ; \(d_i/(d_i^2+\lambda) \approx d_i/\lambda \to 0\).
Le filtre, en image
Sur le diabète
Valeurs singulières : \(d_1 = 42{,}2\) à \(d_{10} = 1{,}9\), rapport 21,7 ; conditionnement de \(\mathbf X^\top\mathbf X\) : 470.
Deux dernières directions : colinéarité s1–s2, exactement celles que ridge écrase en premier.
Ridge : action sur les directions, non les variables. Même changement de base que l’ACP (séance 6) — amortir, non projeter.
Choisir \(\lambda\)
Degrés de liberté effectifs
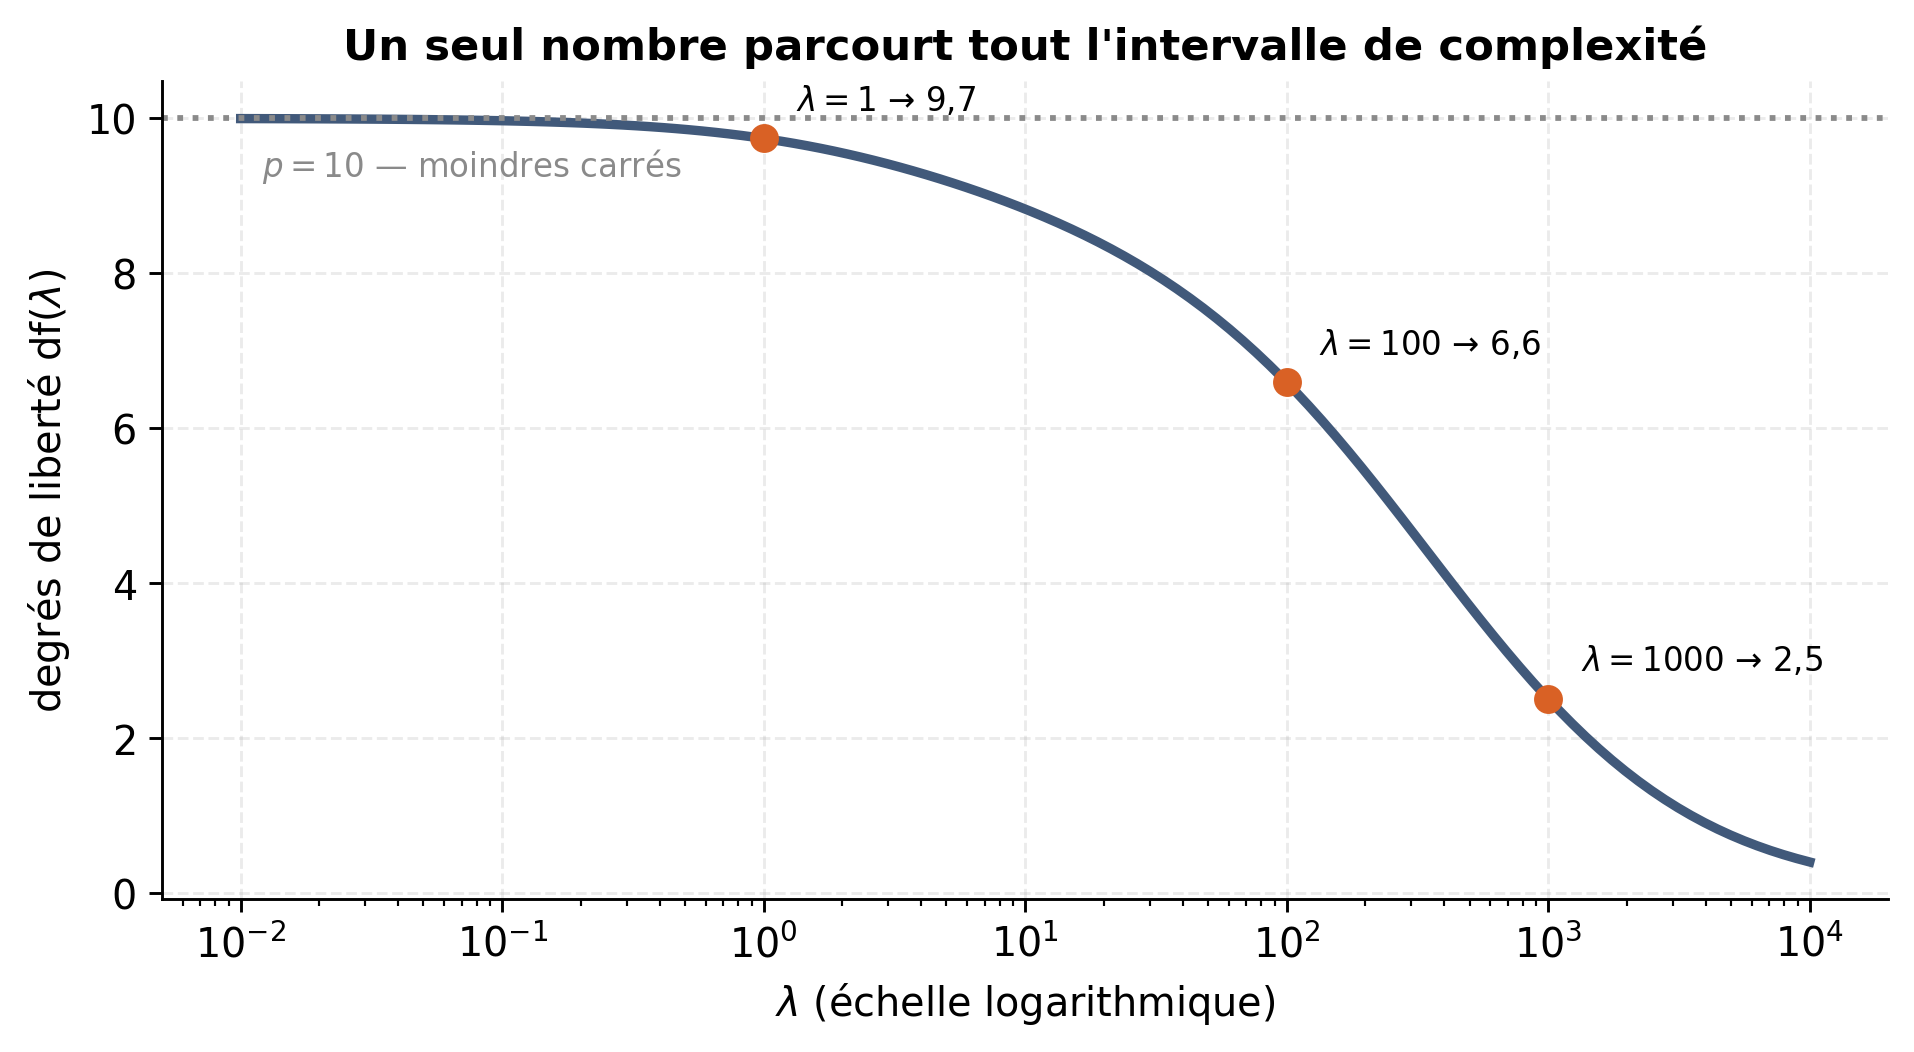
Ridge, estimateur linéaire : \(\widehat{\mathbf y} = \mathbf H_\lambda \mathbf y\) avec \(\mathbf H_\lambda = \mathbf X(\mathbf X^\top\mathbf X + \lambda\mathbf I)^{-1}\mathbf X^\top\).
\[ \mathrm{df}(\lambda) = \operatorname{tr}(\mathbf H_\lambda) = \sum_{i=1}^p \frac{d_i^2}{d_i^2 + \lambda} . \]
\(\mathrm{df}(0) = p\), \(\mathrm{df}(\infty) = 0\). Complexité continue, là où les arbres comptent des feuilles entières.
La complexité, en image
Trois façons de choisir
Critères d’information
\(\mathrm{AIC} = n\log(\mathrm{SCR}) + 2\,\mathrm{df}\)
\(\mathrm{BIC} = n\log(\mathrm{SCR}) + \mathrm{df}\log n\)
Validation croisée
\(K\) plis, méthode de la séance 1. Aucune hypothèse.
Et la validation croisée généralisée, proche du laisser-un-de-côté, sans réajustement :
\[ \mathrm{GCV} = \frac1n \sum_i \left(\frac{y_i - \widehat y_i}{1 - \operatorname{tr}(\mathbf H_\lambda)/n}\right)^2 . \]
La courbe de validation
Le résultat sur le diabète
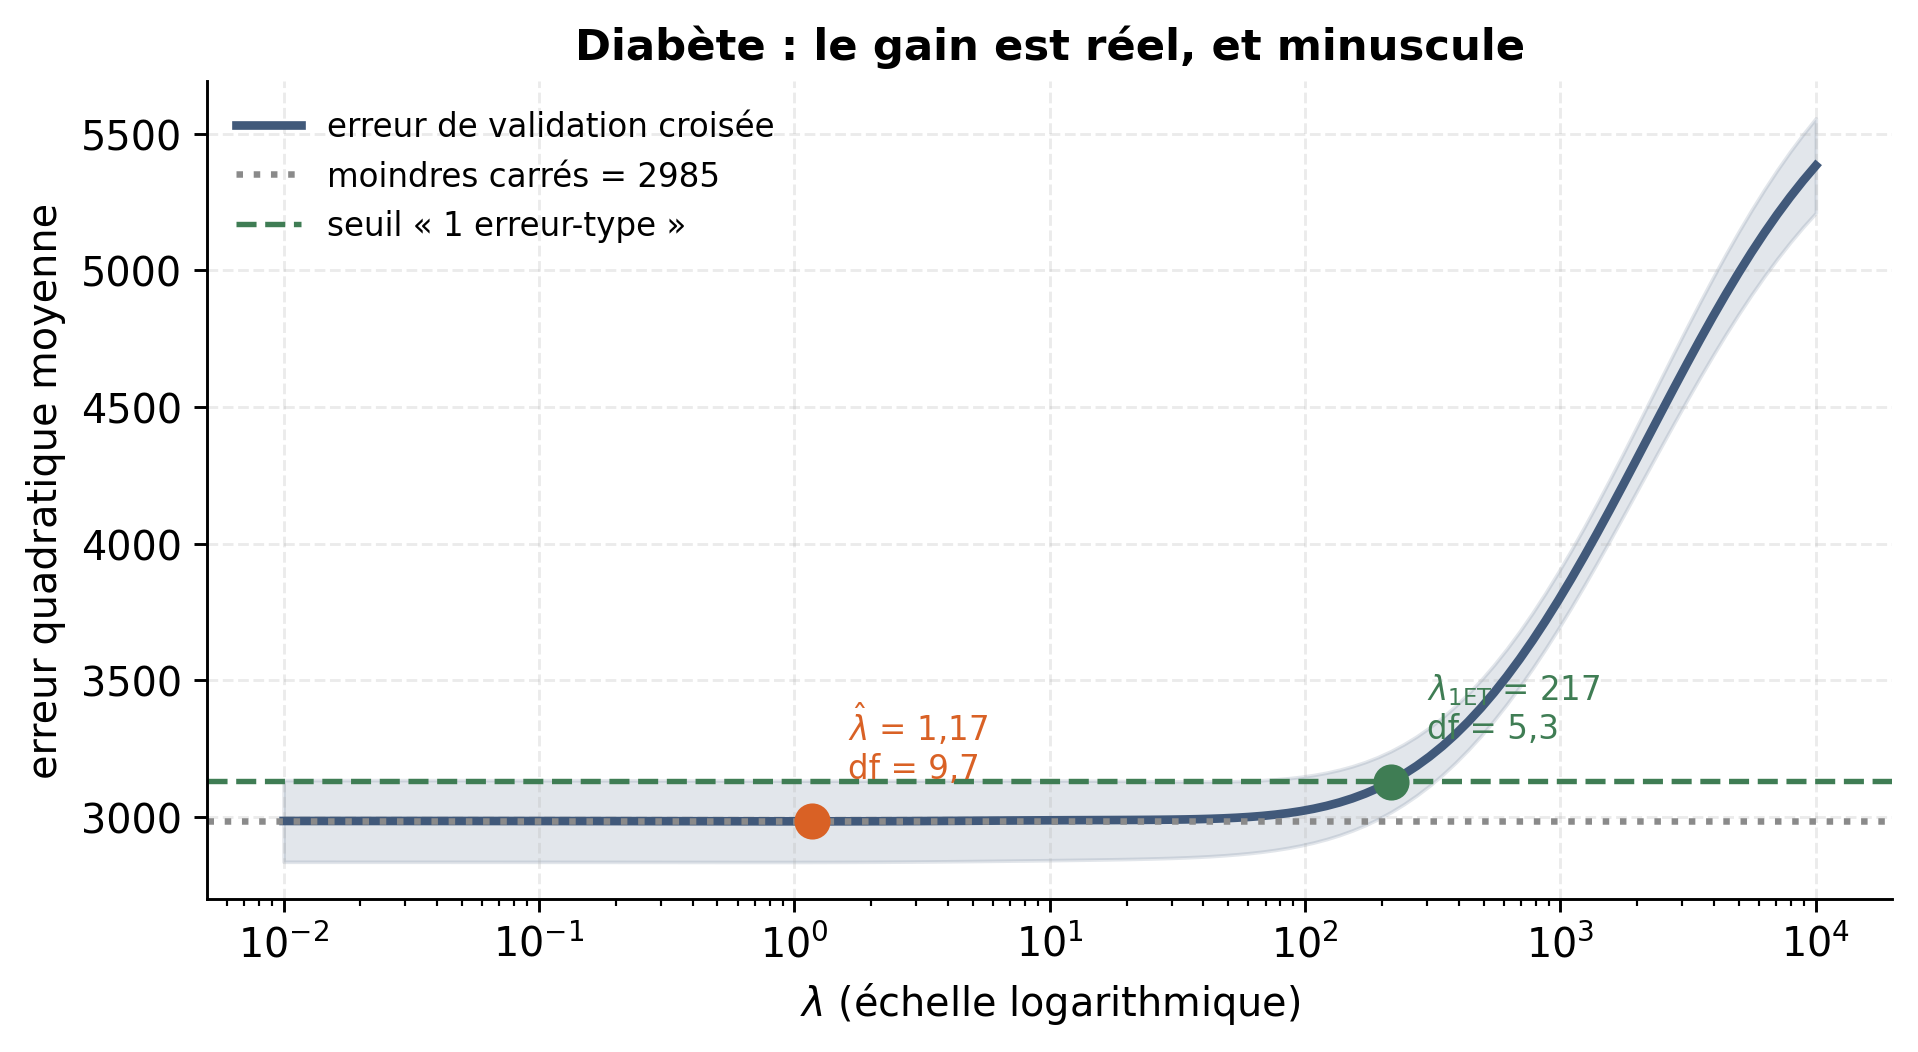
Diabète : \(\widehat\lambda = 1{,}17\), erreur 2 984 contre 2 985 pour les moindres carrés.
Gain : 0,05 %. Théorème vérifié — et inutile sur ce jeu.
Règle du 1 erreur-type (séance 4) : \(\lambda = 217\), soit \(\mathrm{df} = 5{,}3\) — deux fois moins de complexité, 5 % d’erreur en plus.
Raison du faible gain
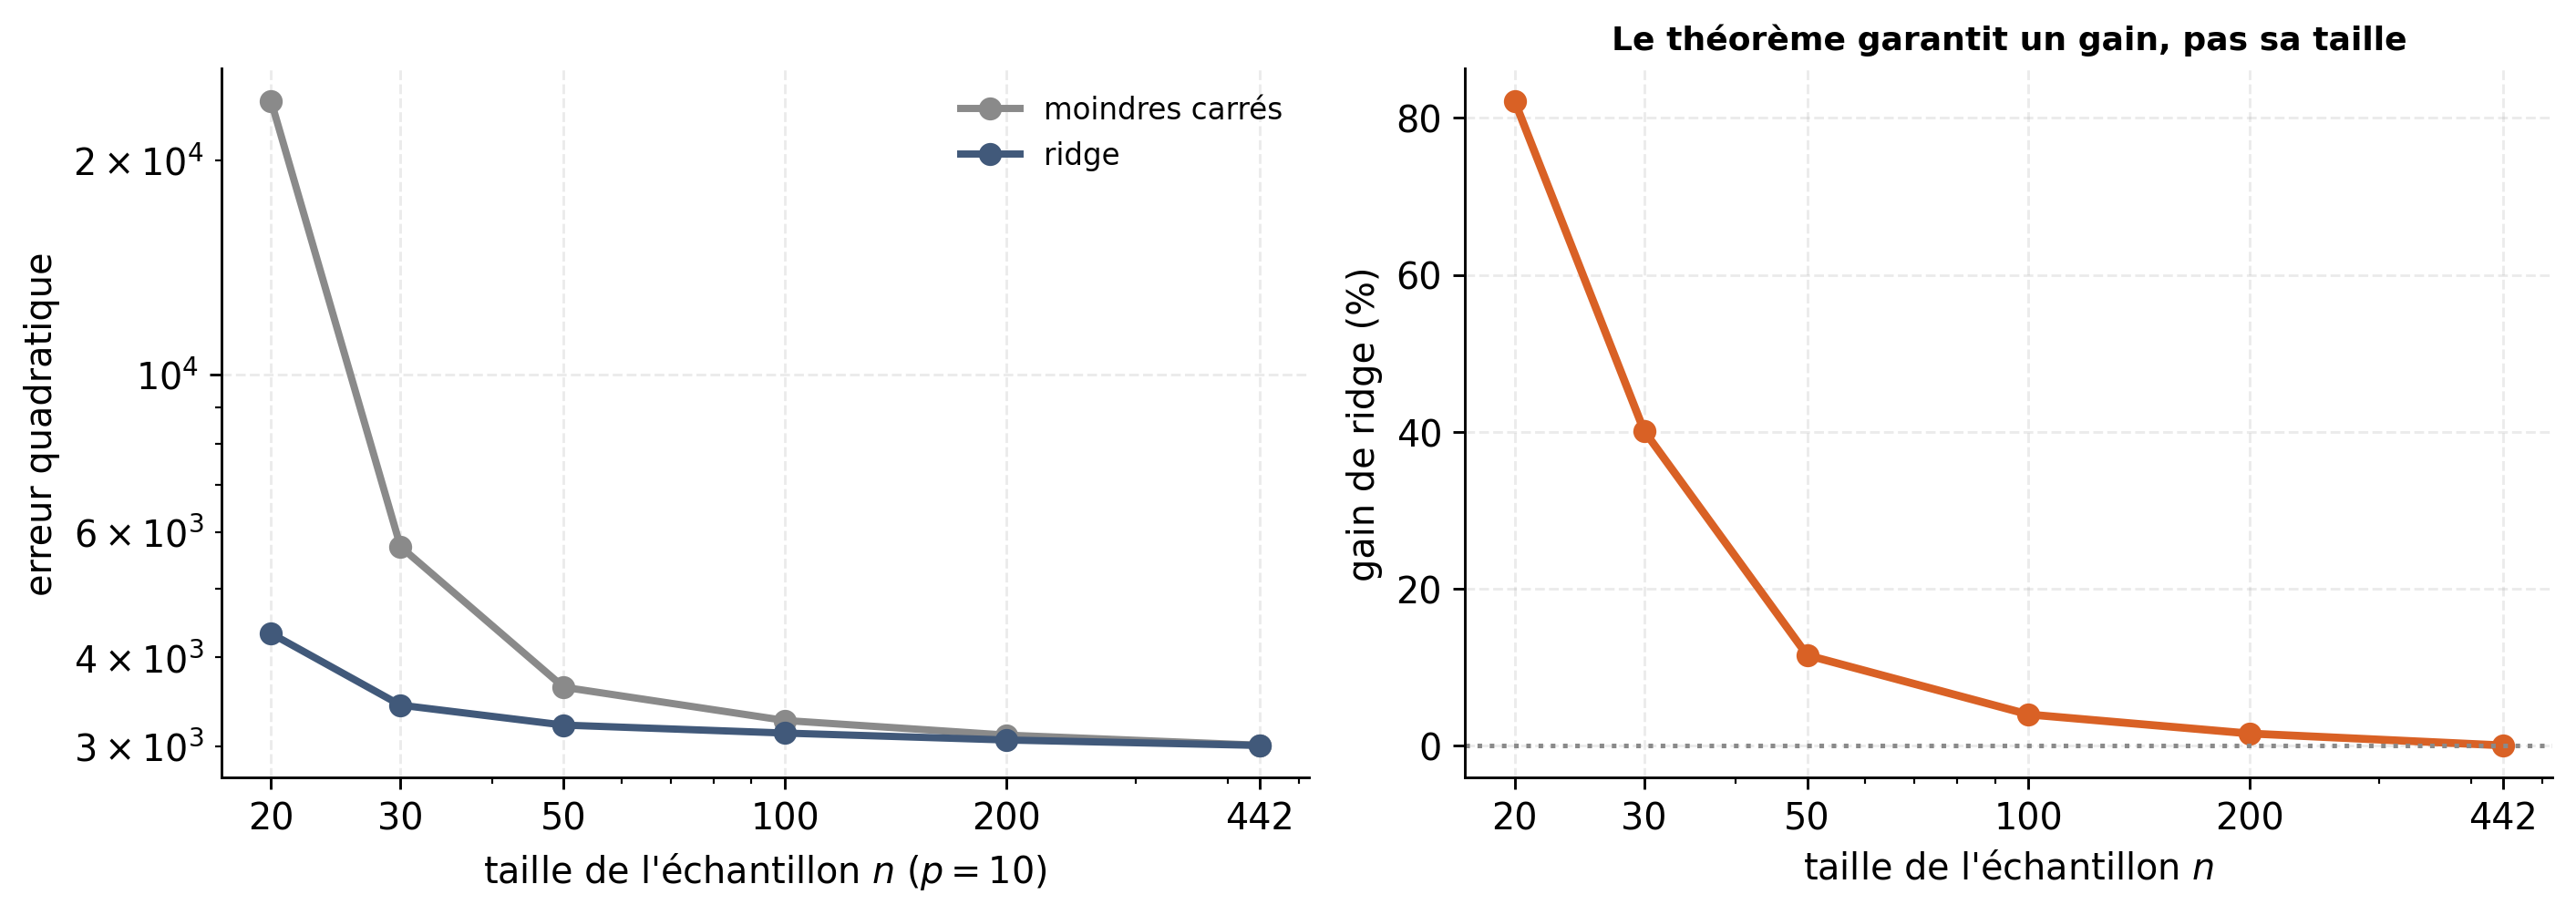
\(n = 442\) pour \(p = 10\) : quarante-quatre observations par paramètre. Variance des moindres carrés déjà faible : presque rien à racheter.
Le vrai régime de ridge
\(n = 20\) : erreur divisée par cinq et demi (24 200 → 4 300).
| \(n\) | 20 | 30 | 50 | 100 | 200 | 442 |
|---|---|---|---|---|---|---|
| gain | 82 % | 40 % | 12 % | 4 % | 2 % | 0 % |
Bénéfice de ridge : fonction de \(p/n\). Beaucoup de données, peu de variables : inutile. L’inverse : indispensable.
En scikit-learn
from sklearn.linear_model import Ridge, RidgeCV
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

modele = make_pipeline(StandardScaler(), Ridge(alpha=1.0))

# alpha choisi par validation croisée sur une grille
grille = np.logspace(-2, 4, 100)
modele = make_pipeline(StandardScaler(), RidgeCV(alphas=grille, cv=10))
modele.fit(X, y)
modele[-1].alpha_
alpha : le \(\lambda\) du cours. Standardisation dans le pipeline : leçon de la séance 3 valable ici aussi.
Limites et suite
Ridge ne sélectionne pas
Chemin de régularisation : tous les coefficients contractés, aucun à zéro pour un \(\lambda\) fini.
Mille variables dont dix utiles : ridge renvoie mille coefficients petits, non dix coefficients et 990 zéros.
Ridge régularise. Ne sélectionne pas.
Origine de la limite
Pénalité \(\|\boldsymbol\beta\|^2\) dérivable en zéro : gradient nul, rien ne pousse un coefficient à s’y arrêter.
Losange à la place de la boule ronde — norme \(\ell_1\) :
\[ \text{lasso} : \quad \|\mathbf y - \mathbf X\boldsymbol\beta\|^2 + \lambda \|\boldsymbol\beta\|_1 . \]
Coins du losange sur les axes : la solution y tombe, zéros exacts. Sujet naturel de la suite.
Le compromis, pour la quatrième fois
| Séance | Modèle | Hyperparamètre | De simple à complexe |
|---|---|---|---|
| 1 | polynômes | degré | ↗ |
| 3 | \(k\)-PPV | \(k\) | ↘ |
| 4 | arbres | \(\alpha\) | ↘ |
| 5 | ridge | \(\lambda\) | ↘ |
Quatre méthodes, un seul schéma : un nombre règle la complexité, la validation croisée le choisit, le jeu de test sert une fois.
En bref
- Variance des moindres carrés explosive en \(\sigma^2/d_i^2\) : colinéarité, \(p\) proche de \(n\), ou \(p > n\).
- Ridge : terme \(\lambda\|\boldsymbol\beta\|^2\) ajouté ; solution toujours existante, même quand celle des moindres carrés n’existe pas.
- Base de la SVD : ridge, filtre qui écrase les directions instables.
- Toujours un \(\lambda > 0\) meilleur que les moindres carrés ; gain dépendant de \(p/n\).
- \(\mathrm{df}(\lambda)\) : mesure de la complexité ; la validation croisée choisit \(\lambda\) ; ridge ne sélectionne aucune variable.