Séance 3 — Une méthode sans modèle
5 octobre 2026
Comment faire sans modèle pour \(f_k\) ?
Réponse naïve : observations proches de \(x\), puis comptage.
\[ \widehat P(Y = q \mid X = x) = \frac{\text{nombre de voisins de classe } q}{\text{nombre de voisins}} \]
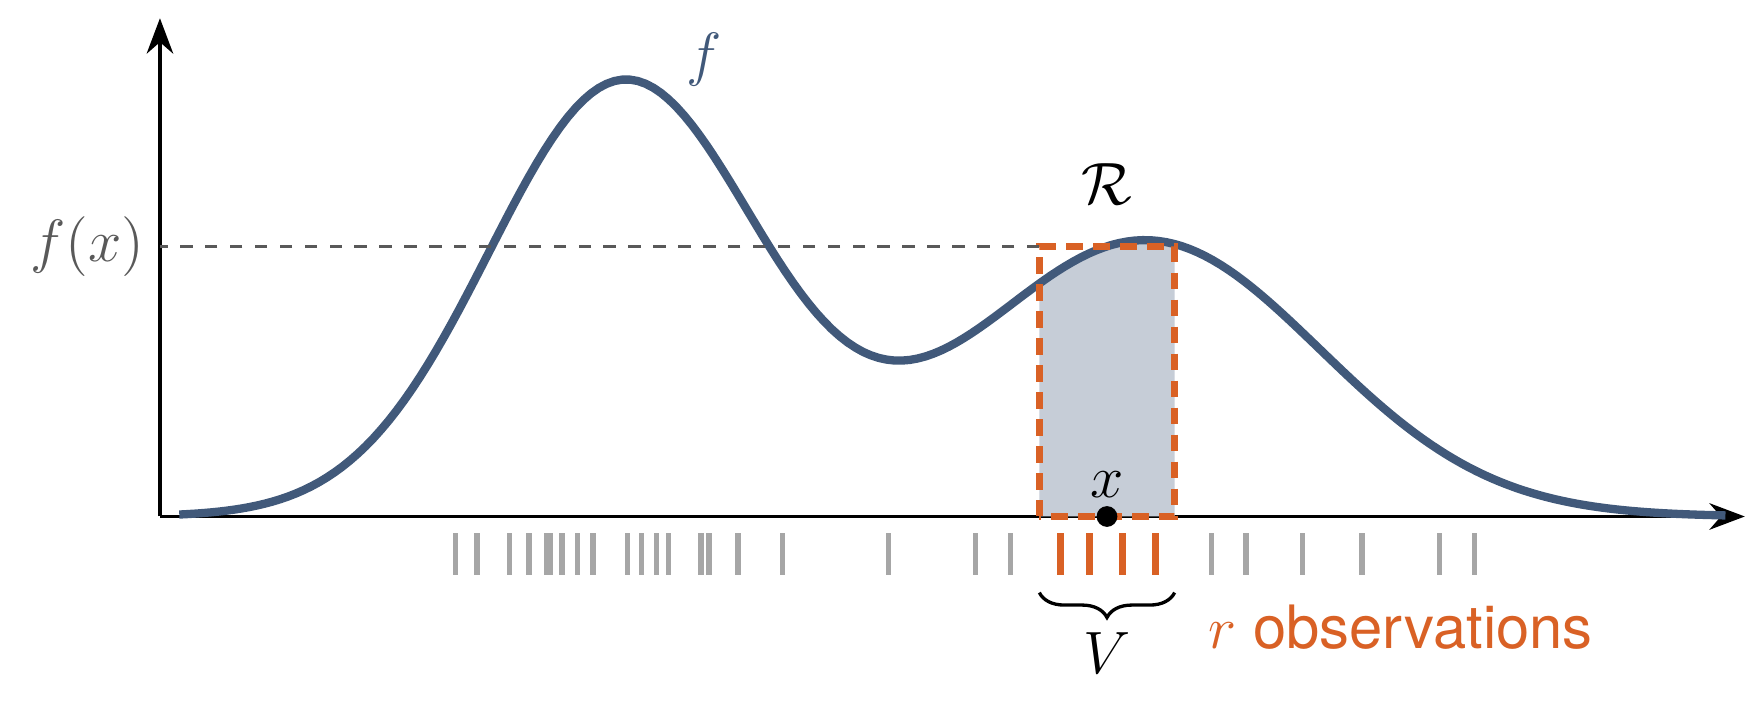
Région \(\mathcal R\) de volume \(V\) autour de \(x\), \(r\) observations sur \(n\) : \(\;f(x)\,V \approx P(X \in \mathcal R) \approx r/n\).
La densité en \(x\) s’estime par la proportion d’observations de la région, rapportée à son volume.
\[ \widehat f(x) = \frac{r}{n\,V} \]
Deux exigences contradictoires.
Volume fixé
Fenêtre de largeur \(h\) autour de \(x\).
Effectif variable.
Zone rare : peu de points.
Effectif fixé
\(k\) plus proches, toujours.
Volume variable.
Zone rare : grand volume.
\(k\)-PPV : effectif fixé, voisinage adaptatif.
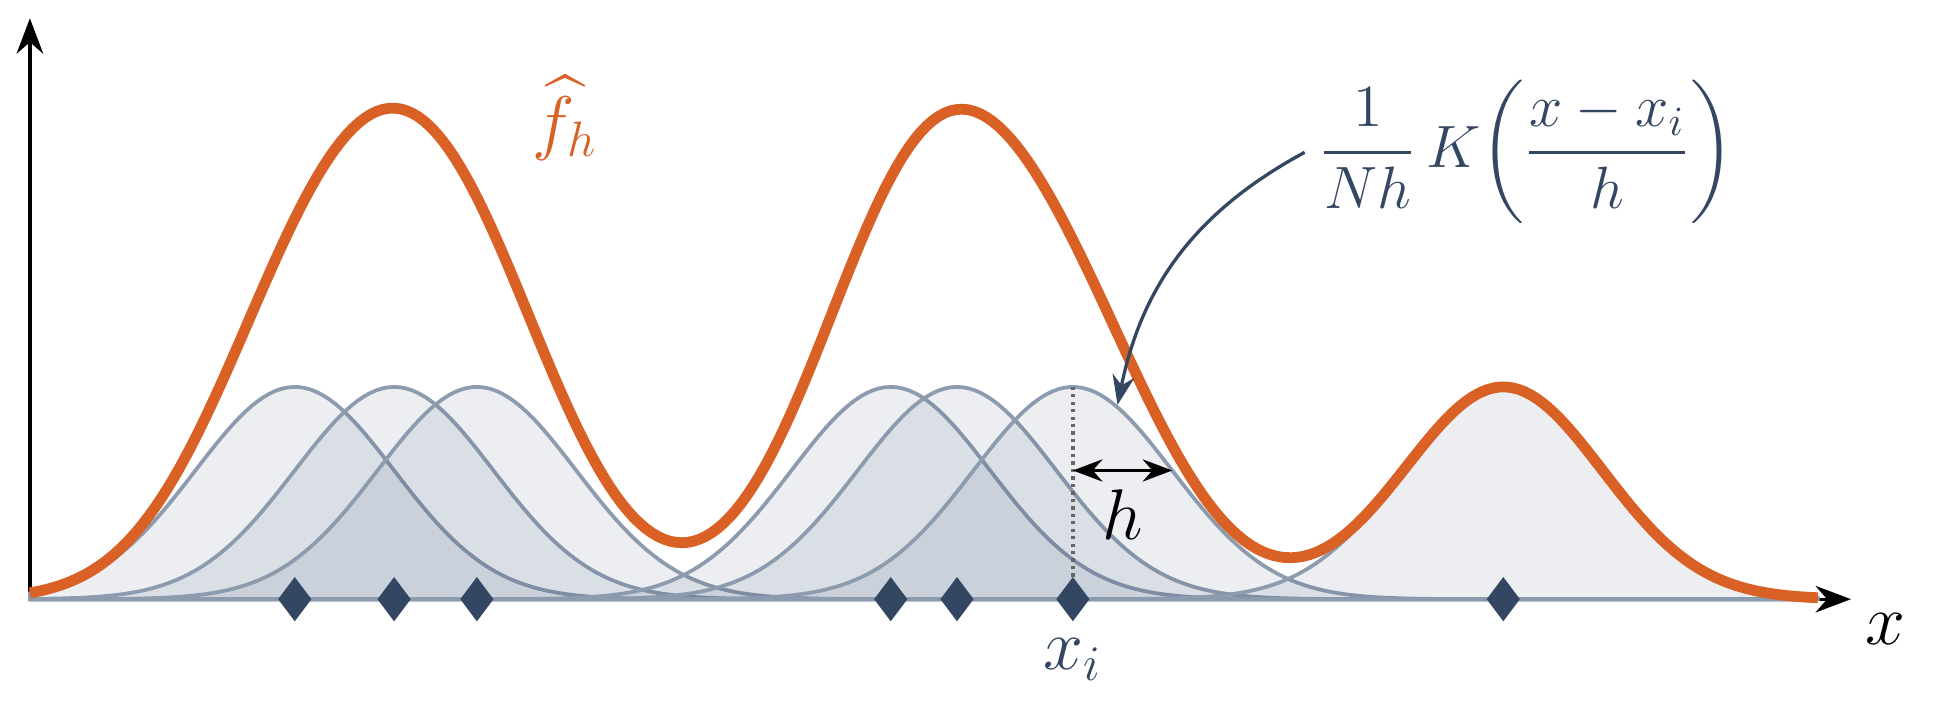
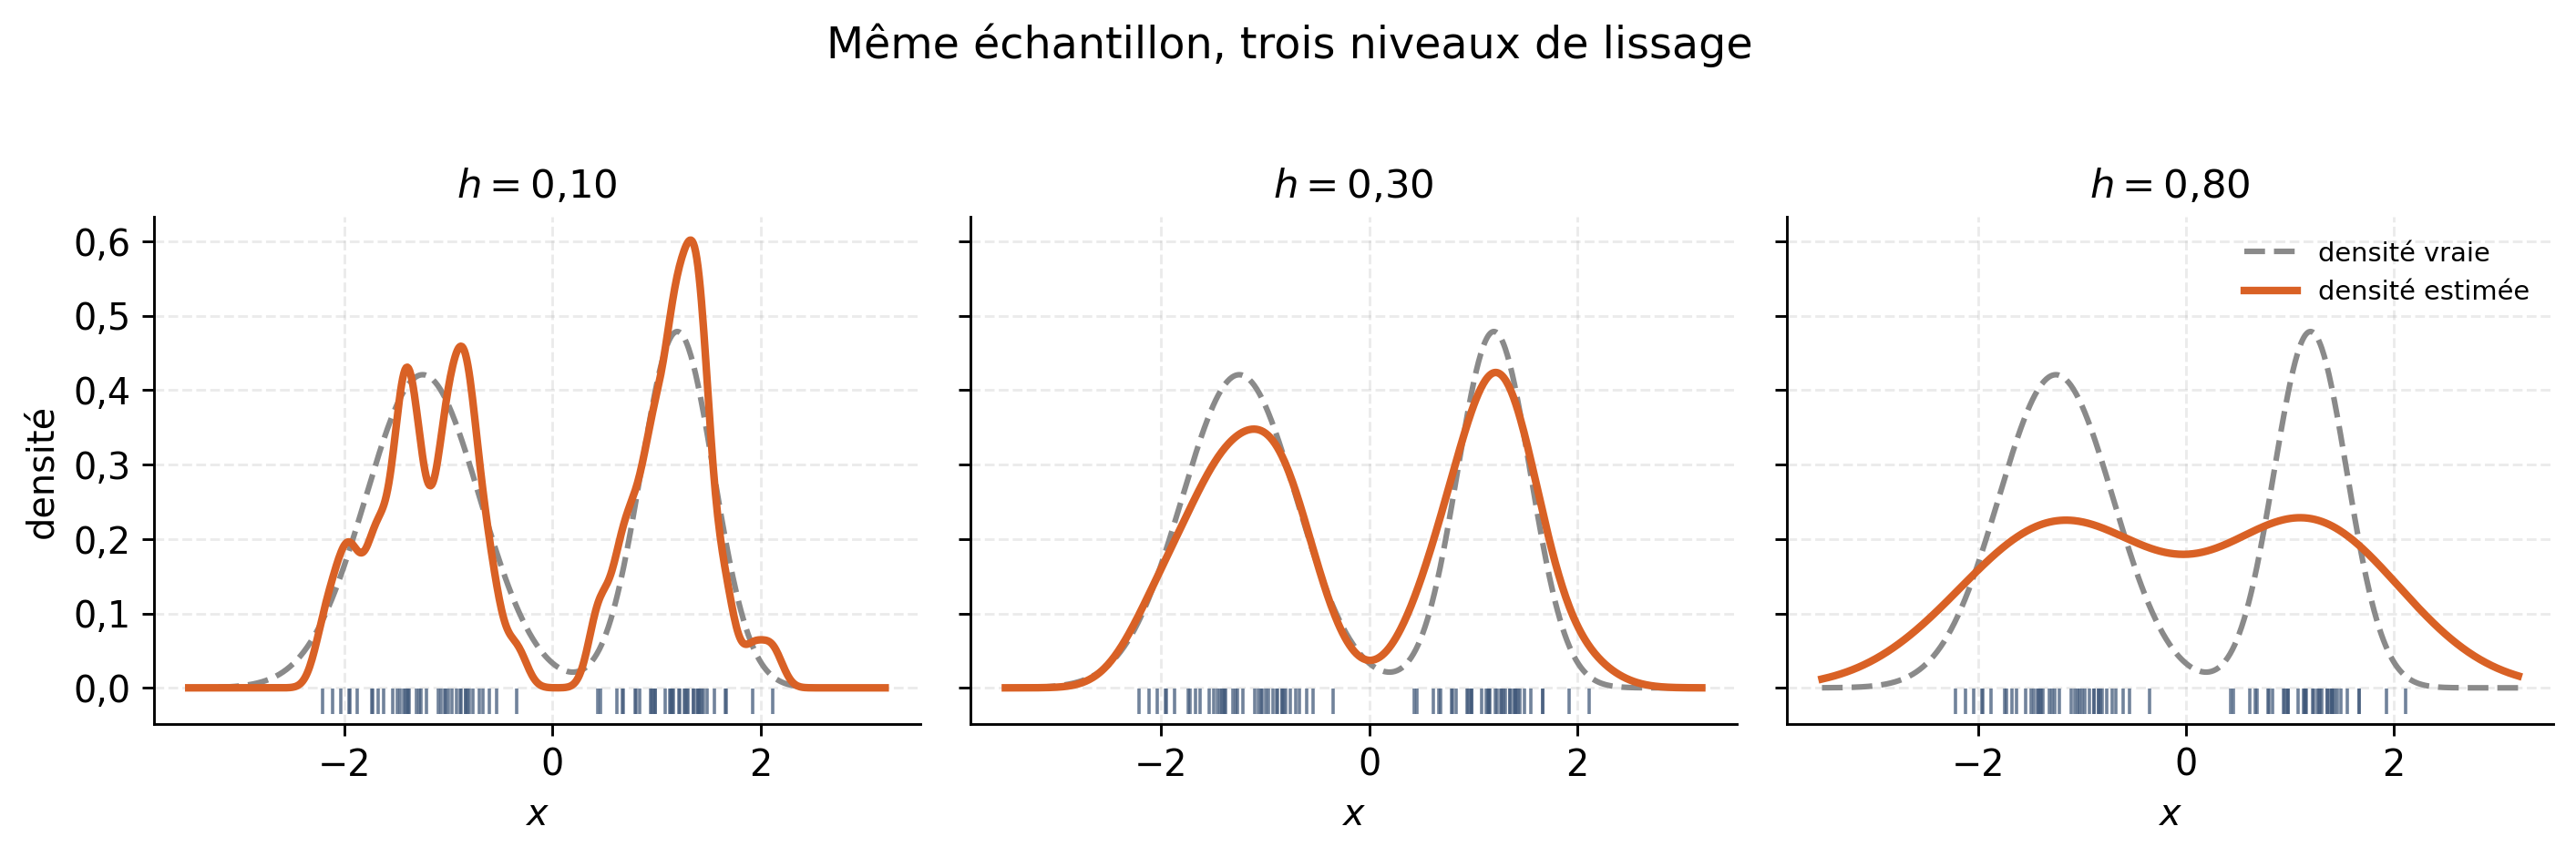
Un noyau par observation ; densité = somme des bosses. Largeur \(h\) : taille du voisinage.
\(h\) petit : densité accidentée. \(h\) grand : densité trop lisse.
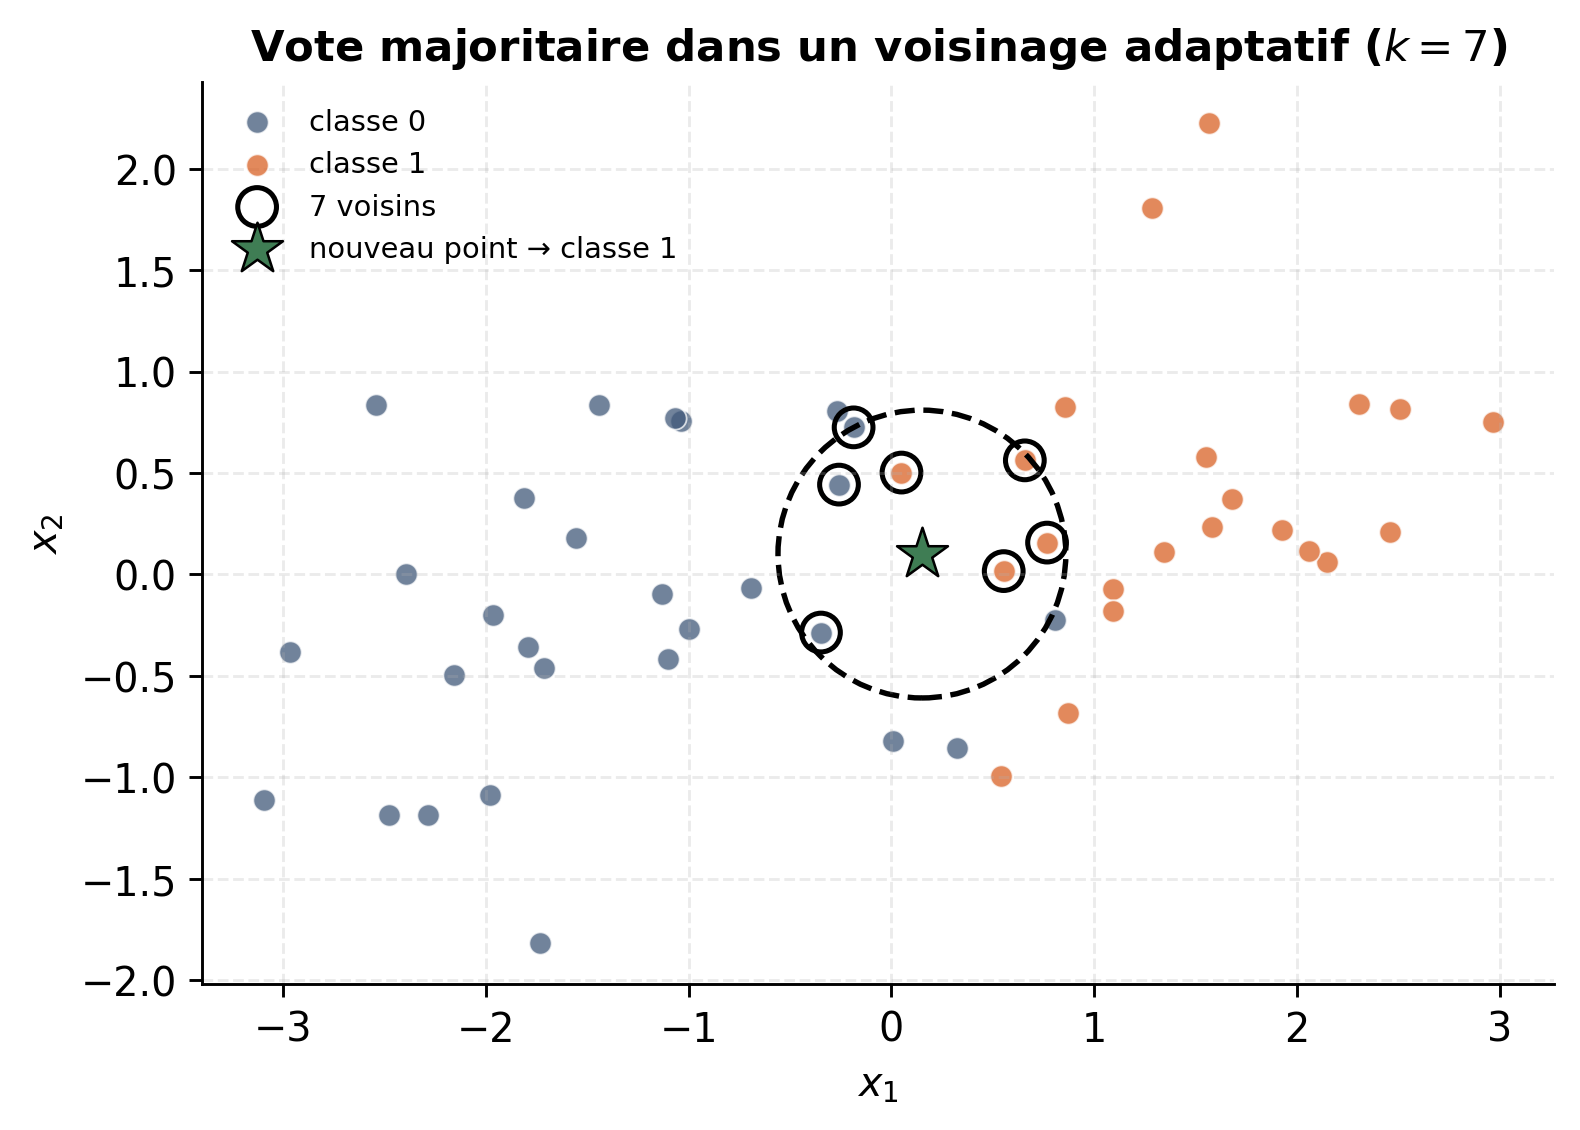
\(V_k(x)\) : volume de la plus petite boule centrée en \(x\) contenant \(k\) observations.
\[ \widehat f(x) = \frac{k}{n\, V_k(x)} . \]
Avec \(k_q\) voisins de classe \(q\) parmi les \(k\), la probabilité a posteriori estimée est la fréquence de la classe \(q\) parmi les voisins.
\[ \widehat P(Y = q \mid X = x) = \frac{\widehat\pi_q \widehat f_q(x)}{\widehat f(x)} = \frac{k_q}{k} . \]
Nouvelle observation \(x\) :
Aucun paramètre ajusté. Apprentissage = stockage des données.
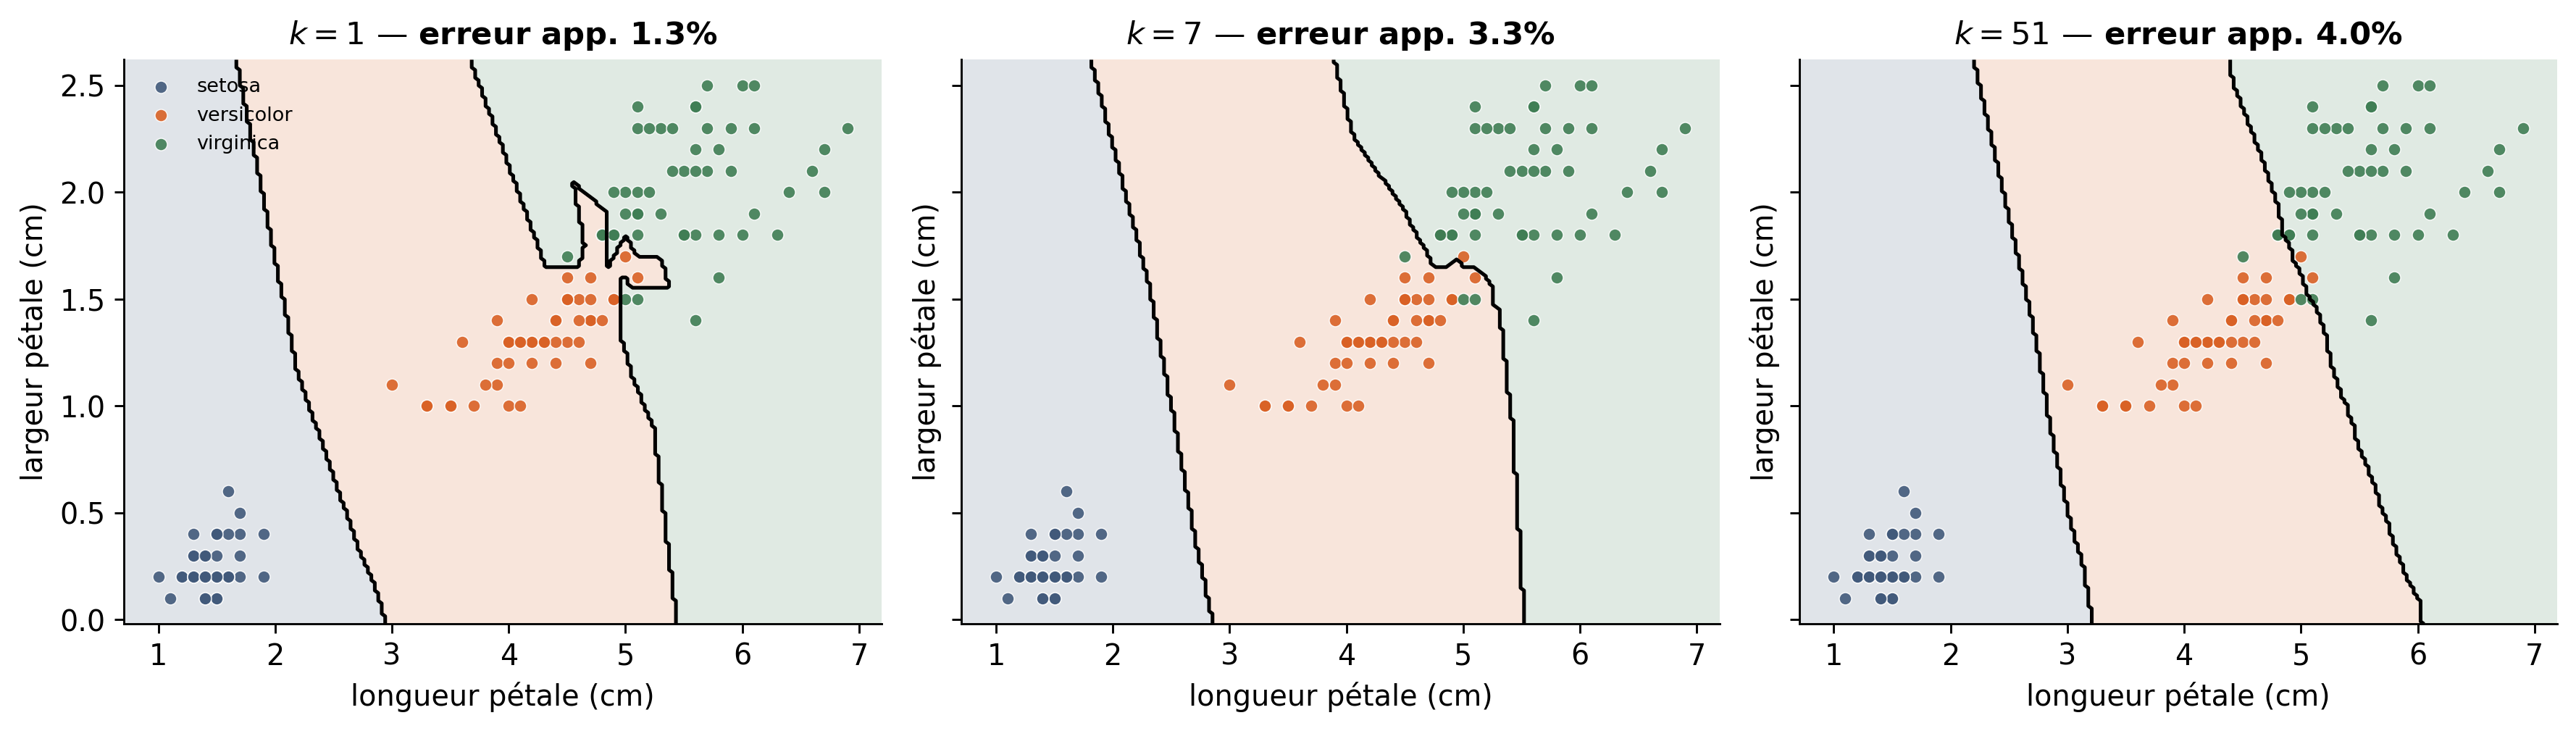
\(k = 1\)
Classe du plus proche voisin.
Frontière irrégulière, sensible au bruit.
\(k = n\)
Vote de tous les points, partout.
Classe majoritaire : classifieur constant de la séance 1.
\(k\) : toute l’échelle, du modèle le plus souple au plus rigide.
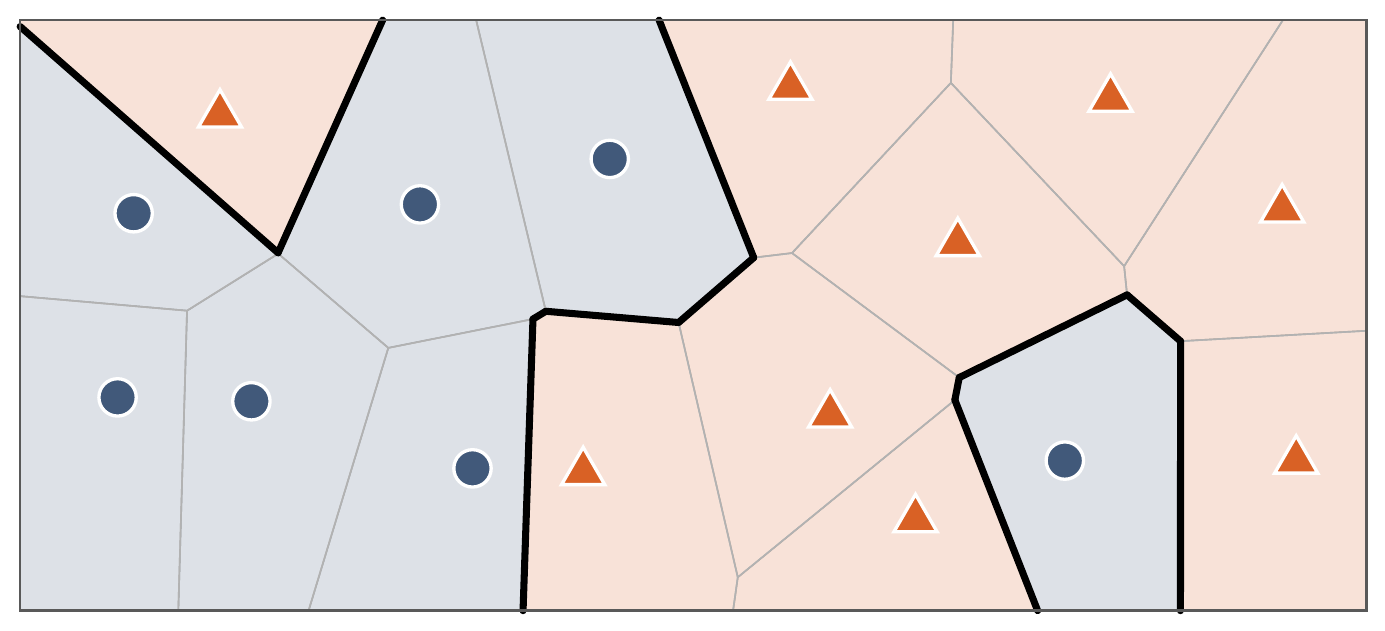
\(k = 1\) : une cellule par observation, ensemble des points dont elle est la plus proche.
Frontière (trait épais) : bords entre cellules de classes différentes. Aspect en escalier.
Erreur presque toujours nulle : chaque point, son propre voisin.
Exception : deux fleurs d’espèces différentes, mêmes mesures.
\(k=1\) au-dessus de 0 % : 48 lignes en double sur les deux mesures de pétale, dont certaines d’espèces différentes.
Vote uniforme :
\[ \widehat P(Y = q \mid X = x) \in \Big\{0,\ \tfrac1k,\ \tfrac2k,\ \dots,\ 1\Big\} . \]
\(k = 7\) : sept valeurs possibles. Seuil et courbe ROC de la séance 1 : résolution grossière.
Vote pondéré par \(1/d(x, x_i)\) : échelle plus fine, calibration toujours imparfaite.
Deux classes, \(k\) pair : égalité possible.
Quelle performance sans modèle ?
Soit \(\eta(x) = P(Y = 1 \mid X = x)\),
sachant \(X = x\) et \(X_{(1)} = x'\), les labels \(Y\) et \(Y'\) sont indépendants (couples i.i.d.), avec \(Y \sim \mathcal B(\eta(x))\) et \(Y' \sim \mathcal B(\eta(x'))\) :
\[ P\big(Y \neq Y' \mid X = x,\ X_{(1)} = x'\big) = \eta(x)\,\big(1 - \eta(x')\big) + \big(1 - \eta(x)\big)\,\eta(x') . \]
Deux erreurs possibles, et si \(\eta\) est continue, \(\eta(X_{(1)}) \to \eta(x)\) et le risque conditionnel tend vers \(2\eta(x)(1-\eta(x))\)
Avec \(n \to \infty\), le plus proche voisin de \(x\) tend vers \(x\) et sa classe suit un tirage selon \(\eta(x)\)
\[ R^\infty_{1\text{-PPV}} = \mathbb E\big[2\,\eta(X)\,(1 - \eta(X))\big] . \]
Soit \(r(x) = \min(\eta(x), 1-\eta(x))\), le risque de Bayes est \(R^* = \mathbb E[r(X)]\).
\[2\eta(1-\eta) = 2\,r\,(1-r) \in [\,r,\ 2r\,].\]
Comme \(u \mapsto 2u(1-u)\) est concave, l’inégalité de Jensen donne la borne de Cover–Hart :
\[R^* \;\le\; R^\infty_{1\text{-PPV}} \;\le\; 2R^*(1-R^*) \;\le\; 2R^* .\]
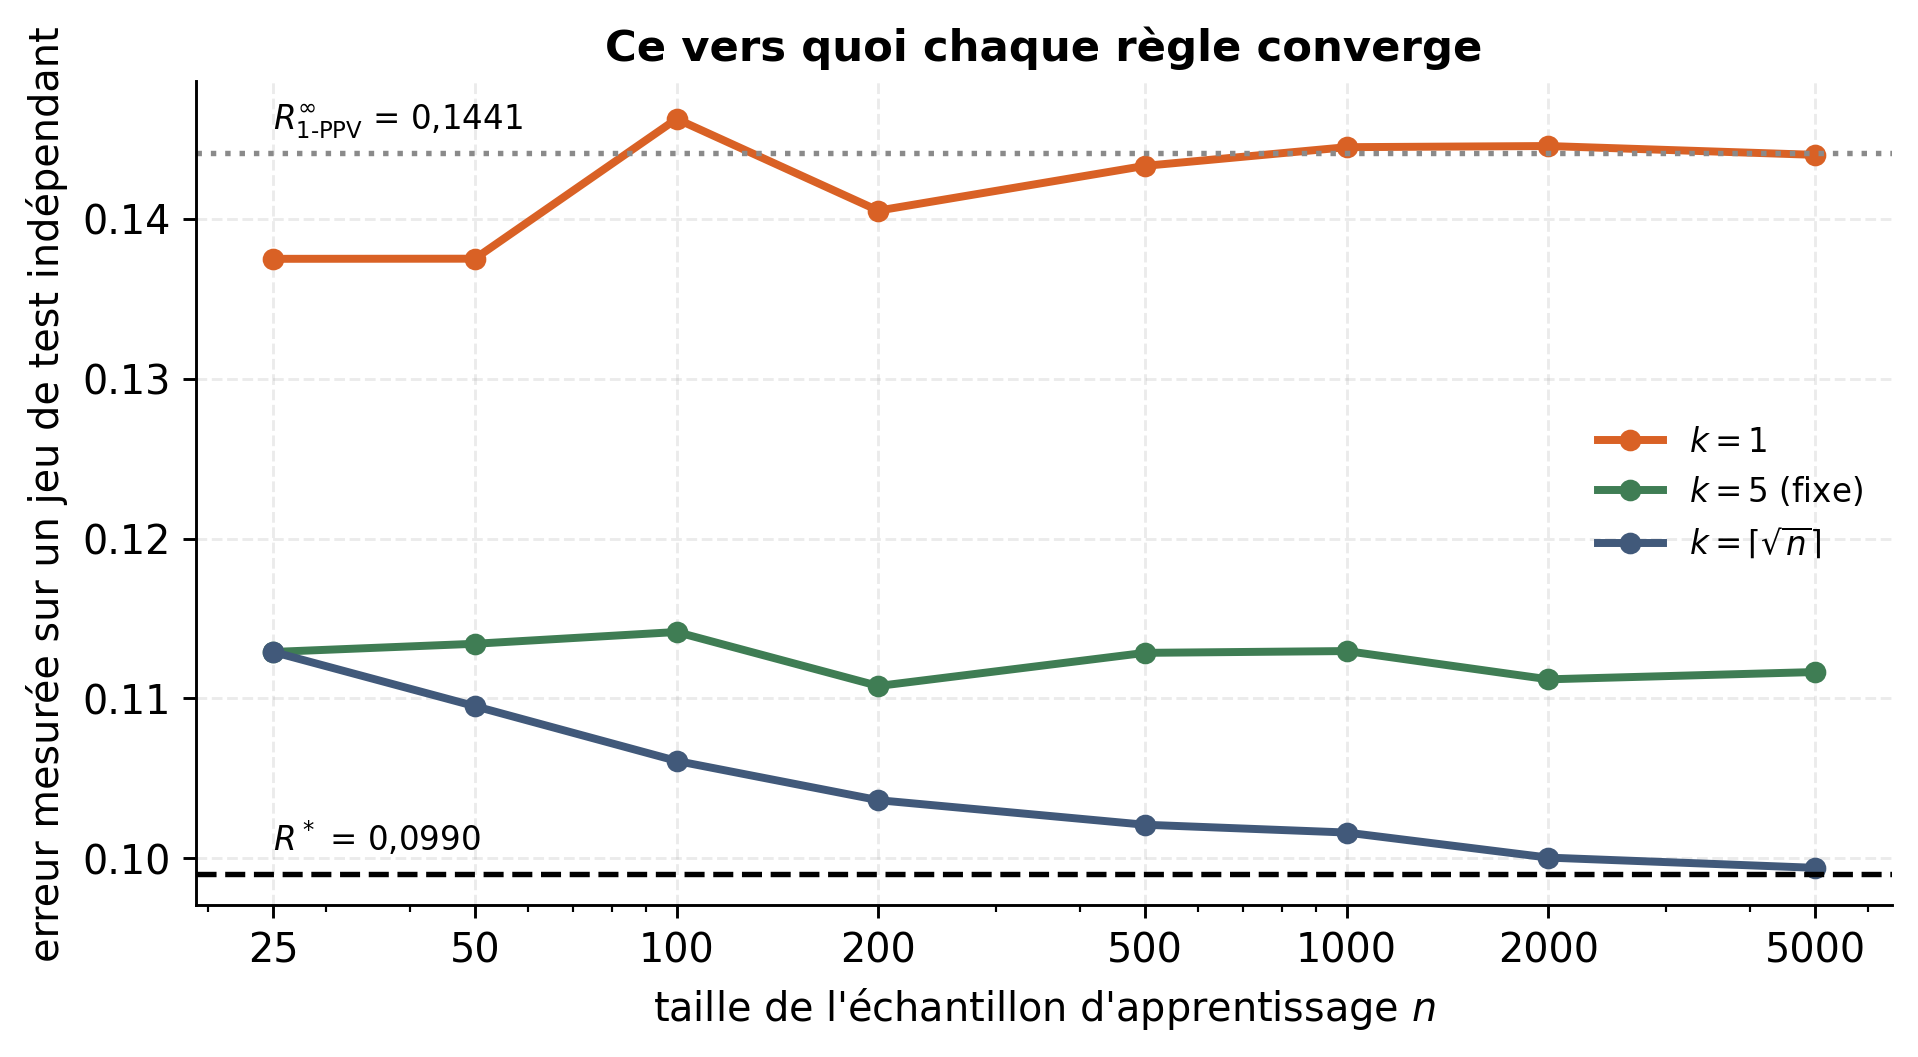
Un seul voisin : jamais plus du double du meilleur risque possible.
1-PPV : pas de convergence vers \(R^*\), bruit de l’étiquette toujours présent.
Les \(k\)-PPV convergent vers le risque de Bayes si le nombre de voisins croît sans limite, mais moins vite que l’échantillon.
\[ k_n \to \infty \qquad\text{et}\qquad \frac{k_n}{n} \to 0 \quad\Longrightarrow\quad R_{k_n\text{-PPV}} \to R^* . \]
\(k_n = \lceil\sqrt n\,\rceil\) : convergence. \(k\) fixe, \(k = n\) : échec.
\(k\)-PPV universellement consistants : optimum atteint sans hypothèse sur la loi. Aucune garantie de ce type en paramétrique.
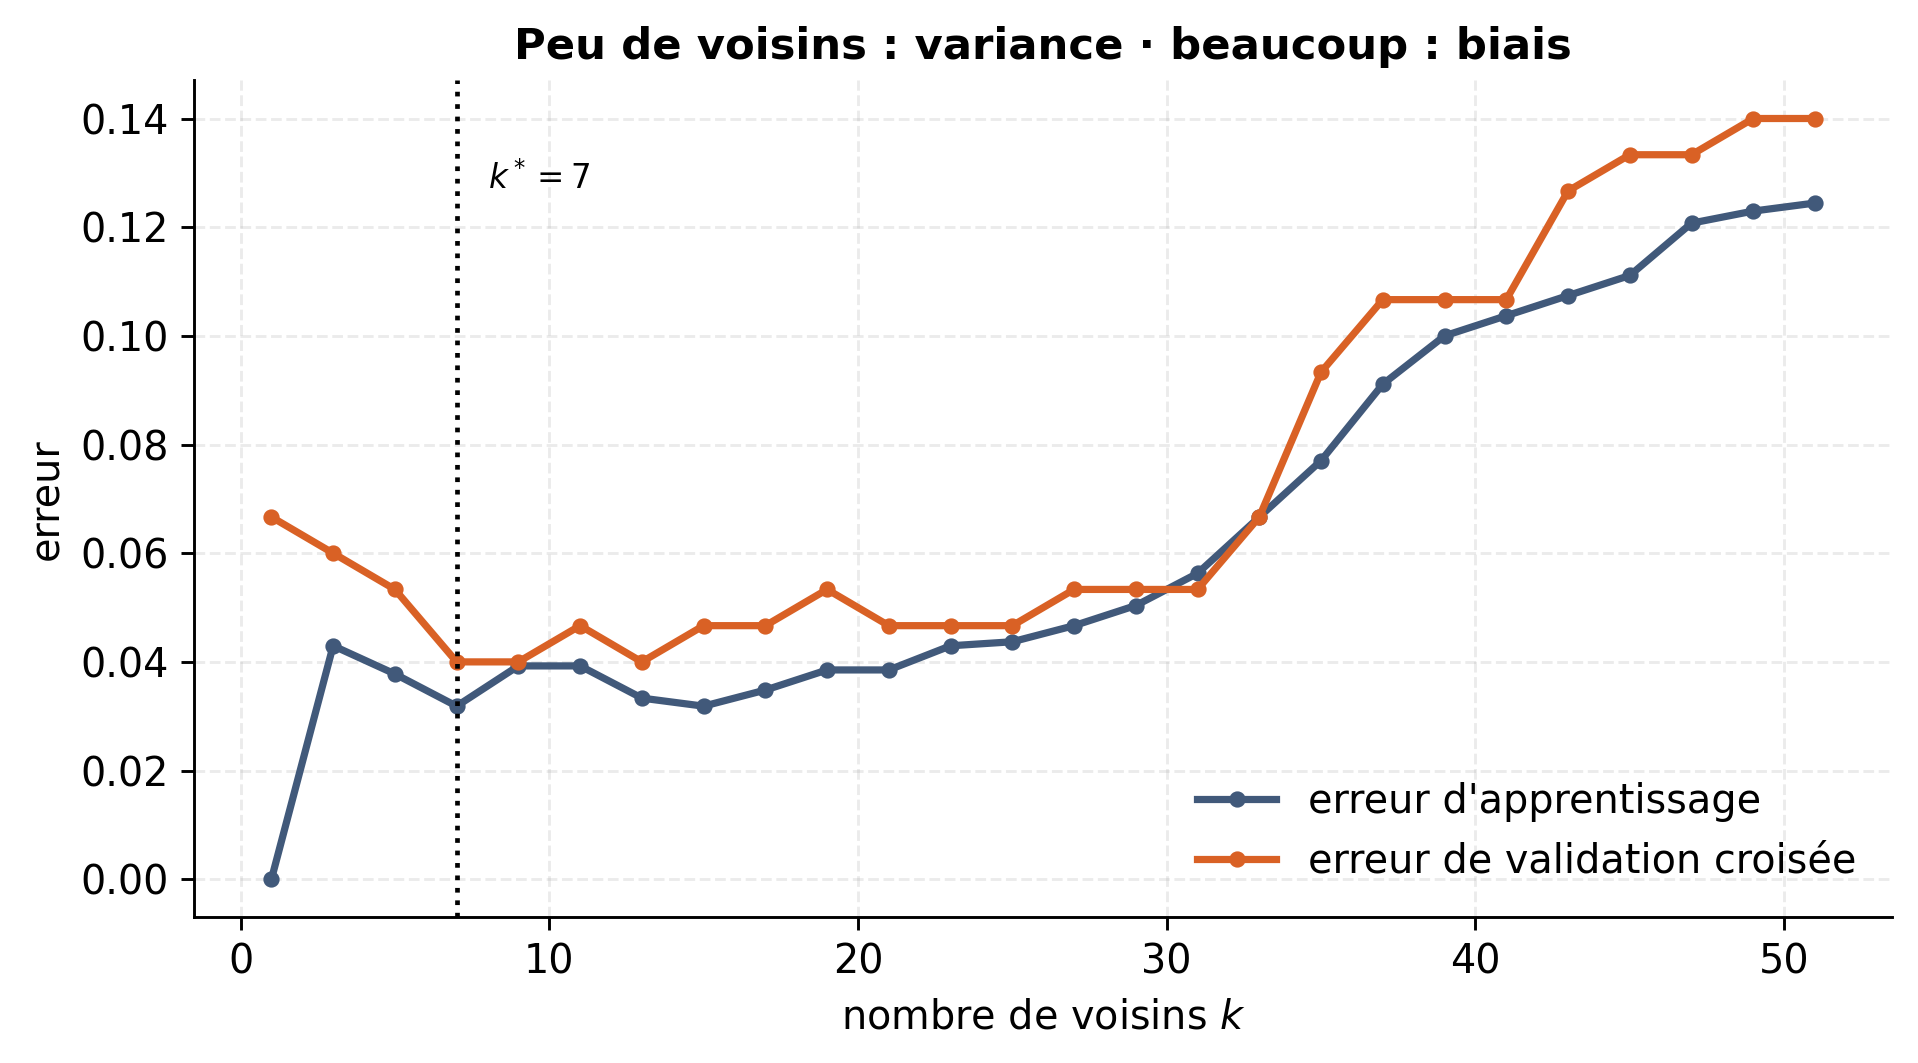
\(k\) petit
Voisinage étroit : biais faible.
Peu de votants : variance forte.
\(k\) grand
Voisinage large, zones hétérogènes moyennées : biais fort.
Beaucoup de votants : variance faible.
Courbe en U de la séance 1, axe de complexité \(1/k\).
\[ d(x, z) = \sqrt{\sum_{j=1}^d (x_j - z_j)^2} \]
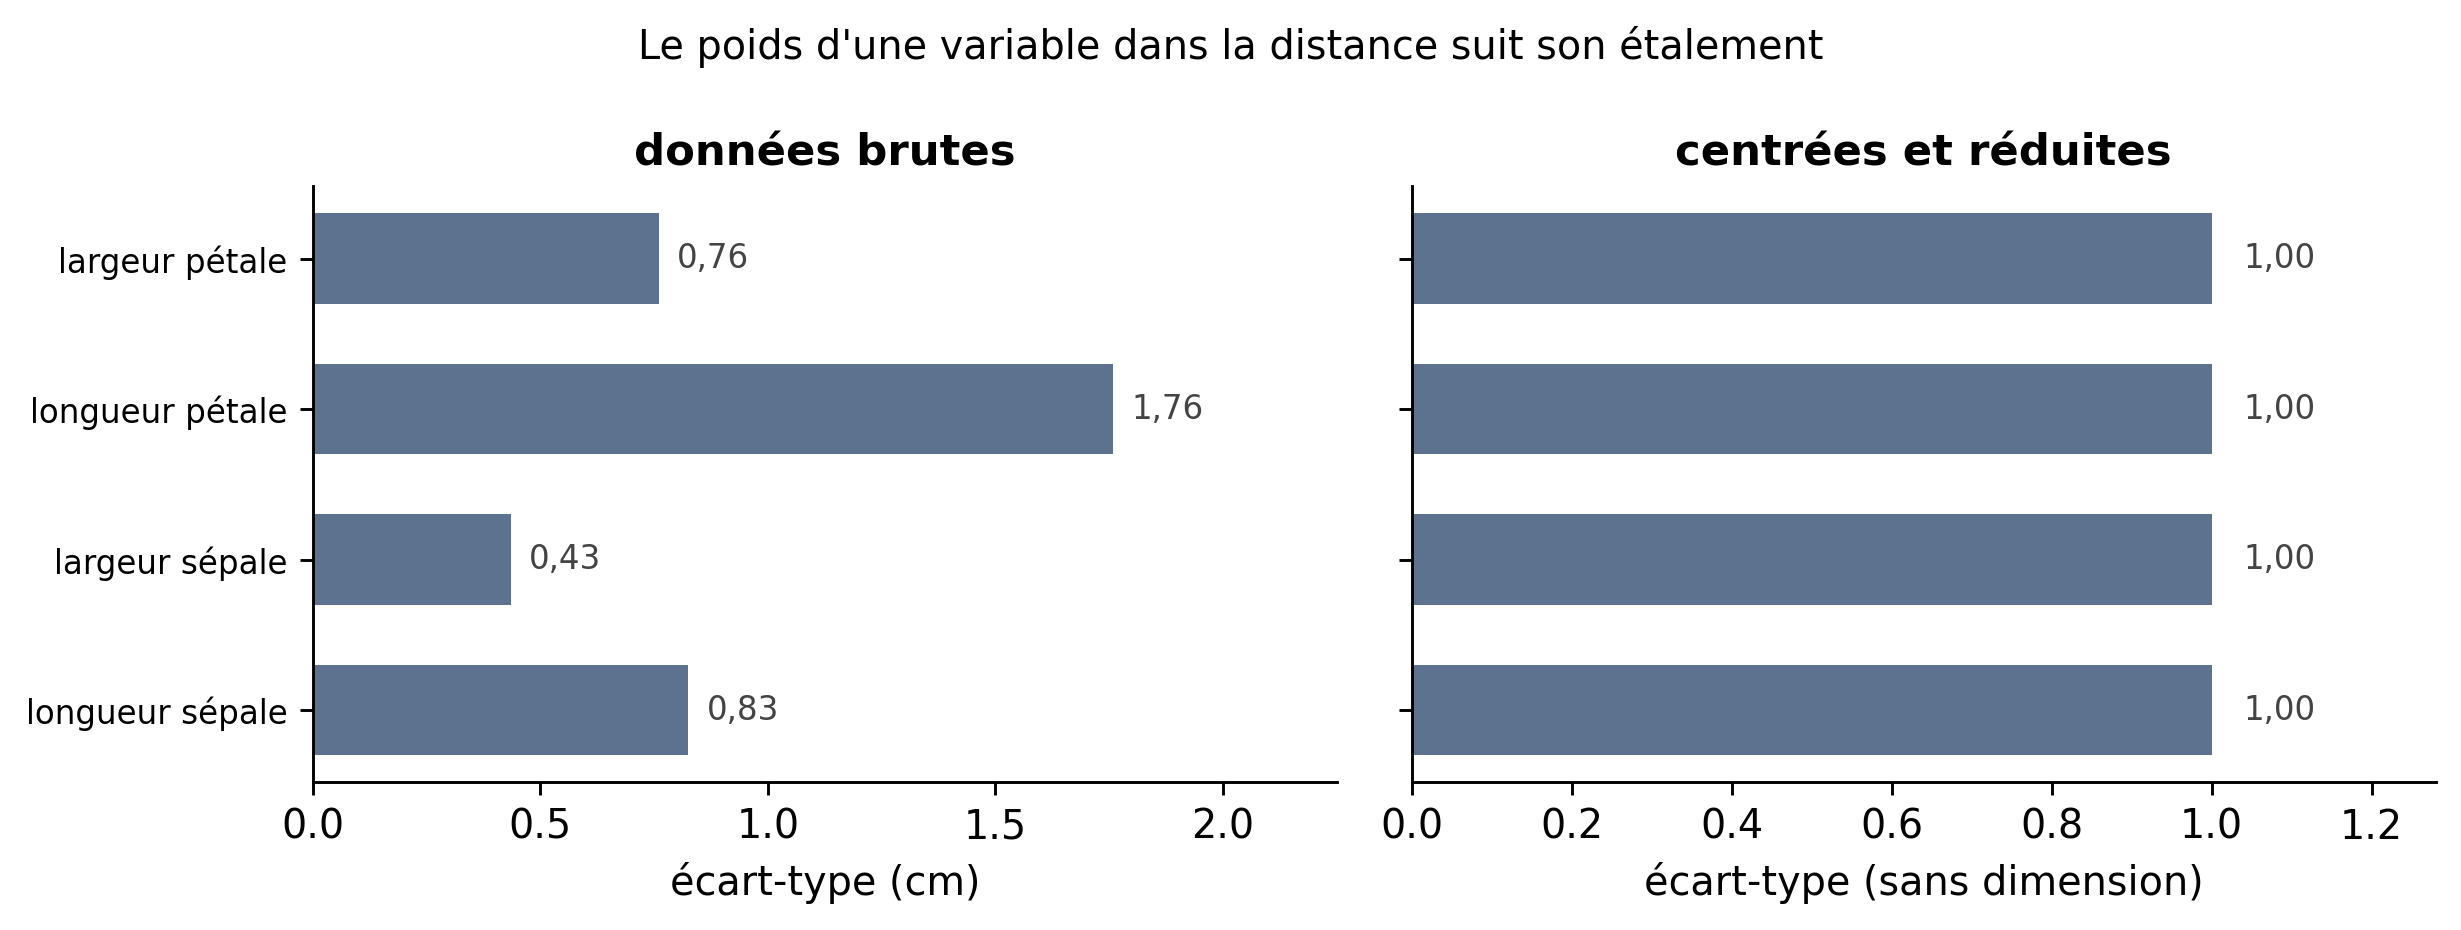
Contribution de chaque variable : carré de son écart. Étalement × 10 → poids × 100.
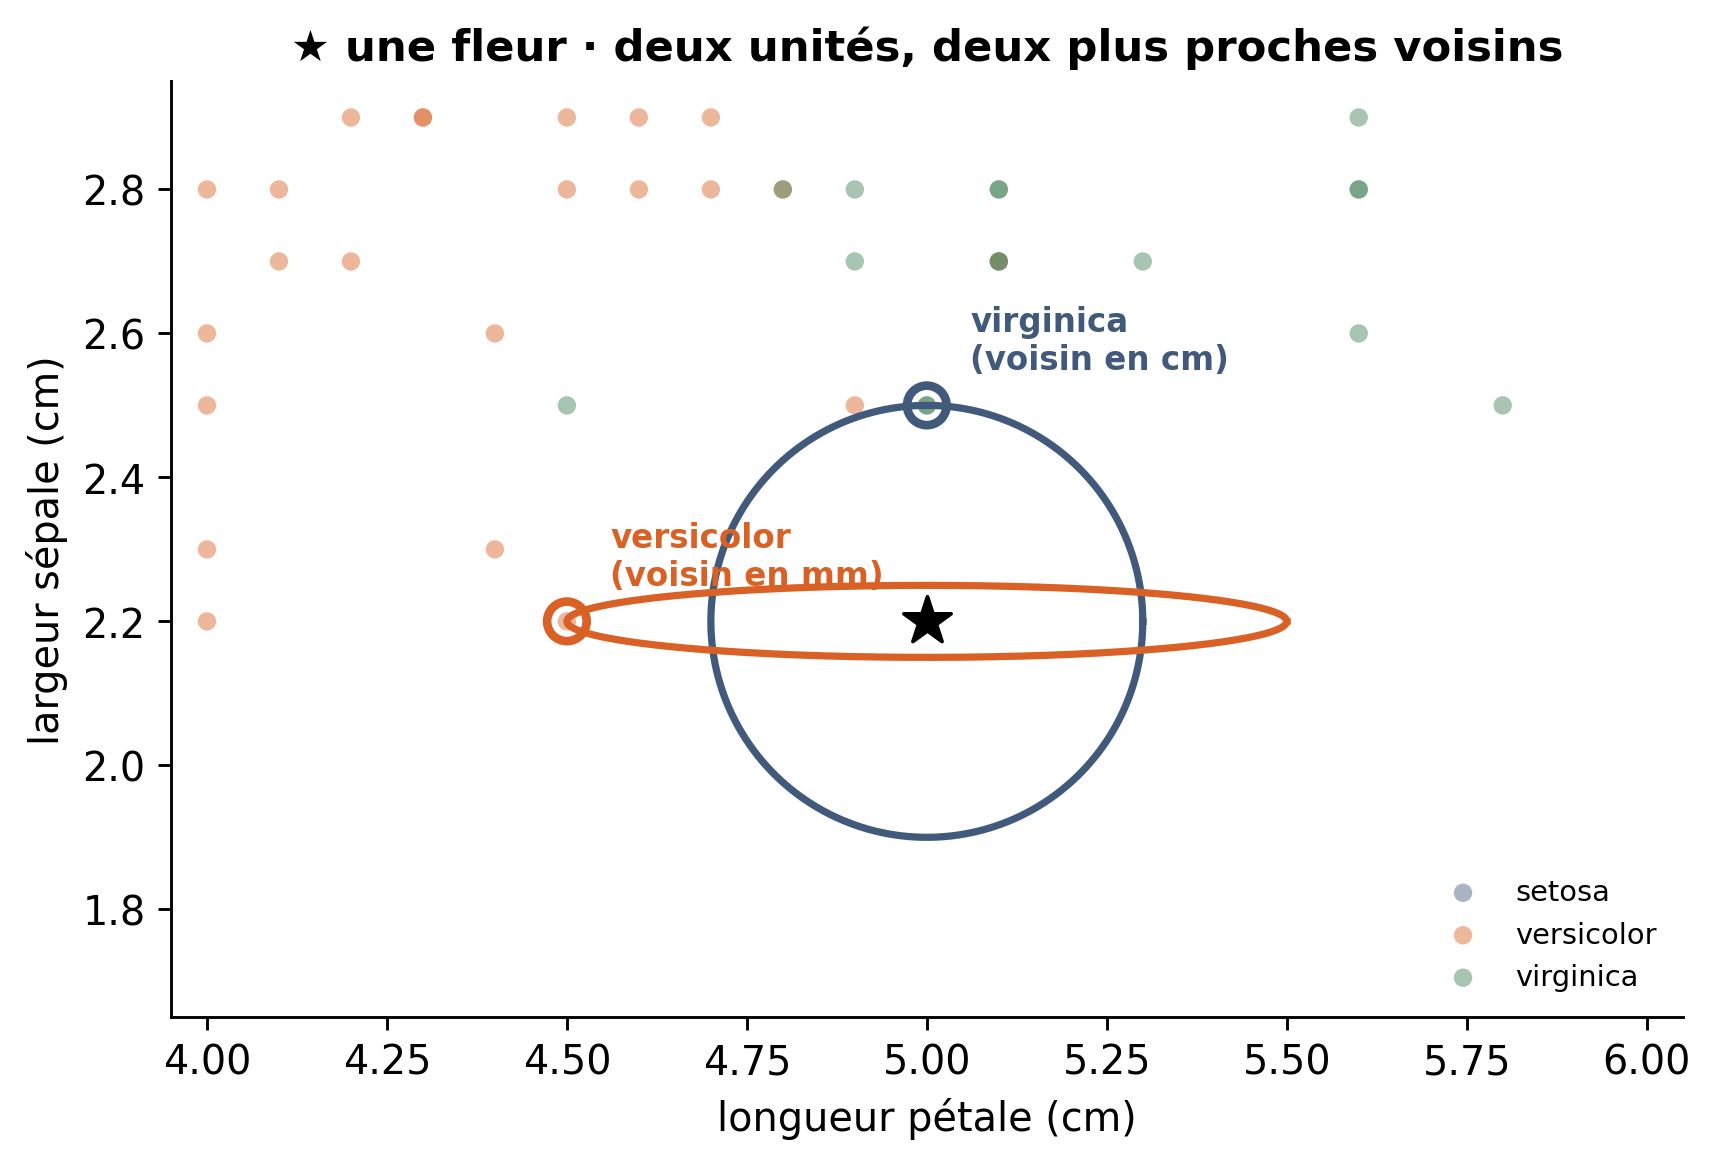
Choix d’une unité = choix implicite d’un modèle.
Même fleur, mêmes données. Largeur de sépale en millimètres : autre plus proche voisin, autre espèce.
Iris entièrement en centimètres : problème d’étalement, pas d’unité.
\[ z_j = \frac{x_j - \widehat\mu_j}{\widehat\sigma_j} \]
Poids égal pour chaque variable. Choix par défaut raisonnable, pas vérité : variable connue pour compter davantage → poids supérieur.
Apprentissage seul, jamais le jeu complet.
Standardisation avant découpage : information du test dans l’apprentissage, fuite de la séance 1.
Effet faible sur Iris, massif sur un jeu déséquilibré ou petit. Règle non négociable.
make_pipeline : prétraitement lié au classifieur. Validation croisée → standardisation réestimée dans chaque pli.
Séance 2 : \(d_\Sigma^2(x, \mu) = (x-\mu)^\top \Sigma^{-1} (x-\mu)\).
Standardisation = \(\Sigma = \operatorname{diag}(\sigma_j^2)\) : étalements corrigés, corrélations ignorées.
Distance euclidienne après blanchiment complet = distance de Mahalanobis. Métrique = modèle.
Erreur d’apprentissage inutile : décroissante avec \(1/k\), quasi nulle en \(k = 1\).
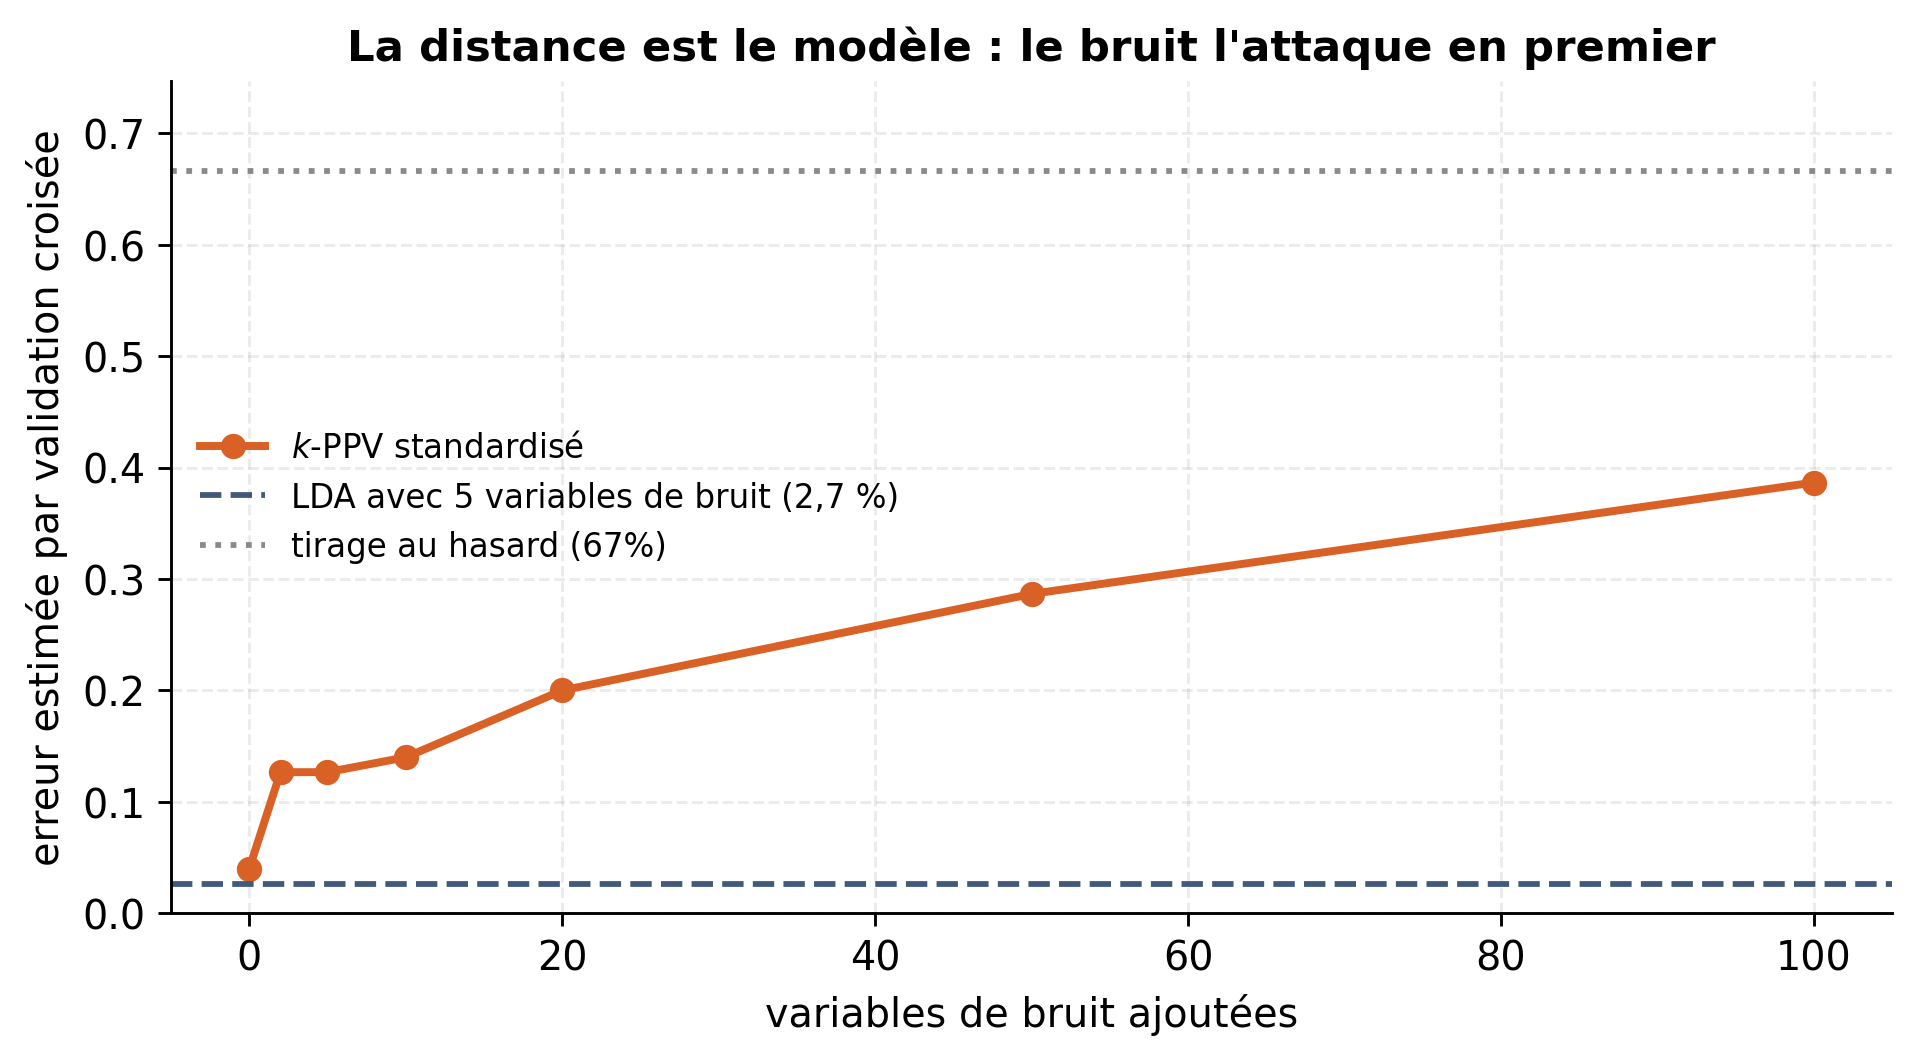
\[ d_{d+1}^2(x, z) = d_d^2(x, z) + (x_{d+1}- z_{d+1})^2 \]
Terme ajouté positif, sans information sur \(Y\). Même bruit dans toutes les distances, écart informatif noyé.
Aucune compensation : pas de coefficient à annuler, contrairement à LDA.
Apprentissage
Stockage des données. Coût nul.
Prédiction
\(n\) distances en dimension \(d\) par point : \(O(nd)\).
Index spatiaux (kd_tree, ball_tree) : gain en dimension modérée, perdu au-delà d’une vingtaine de variables — même fléau.
Apprentissage gratuit, prédiction coûteuse : inverse des modèles paramétriques.