Modèles gaussiens et Bayes naïf
Séance 2 — Loi normale multivariée, Bayes naïf, LDA, QDA
Christophe Ambroise 
UEVE, UMR CNRS 8071
4 septembre 2026
La loi normale multivariée
Le point de départ
En classification, la règle de Bayes choisit la classe :
\[ \arg\max_{k} P(Y = k \mid X = x) = \arg\max_k \frac{\pi_k f_k(x)}{\sum_\ell \pi_\ell f_\ell(x)} \]
Deux quantités à estimer. La proportion \(\pi_k\) se compte. La densité \(f_k\) se modélise.
L’approche paramétrique donne une forme à \(f_k\), puis estime ses paramètres.
La gaussienne
Calculs explicites, géométrie claire, interprétation directe des paramètres.
Pour \(x \in \mathbb R^d\), moyenne \(\mu\), covariance \(\Sigma\) définie positive :
\[ f(x) = \frac{1}{(2\pi)^{d/2} |\Sigma|^{1/2}} \exp\left( -\tfrac{1}{2} (x - \mu)^\top \Sigma^{-1} (x - \mu) \right) \]
\[ (x - \mu)^\top \Sigma^{-1} (x - \mu) = \text{constante} \]
Équation d’un ellipsoïde. Isodensités : des ellipses.
Interprétation des paramètres
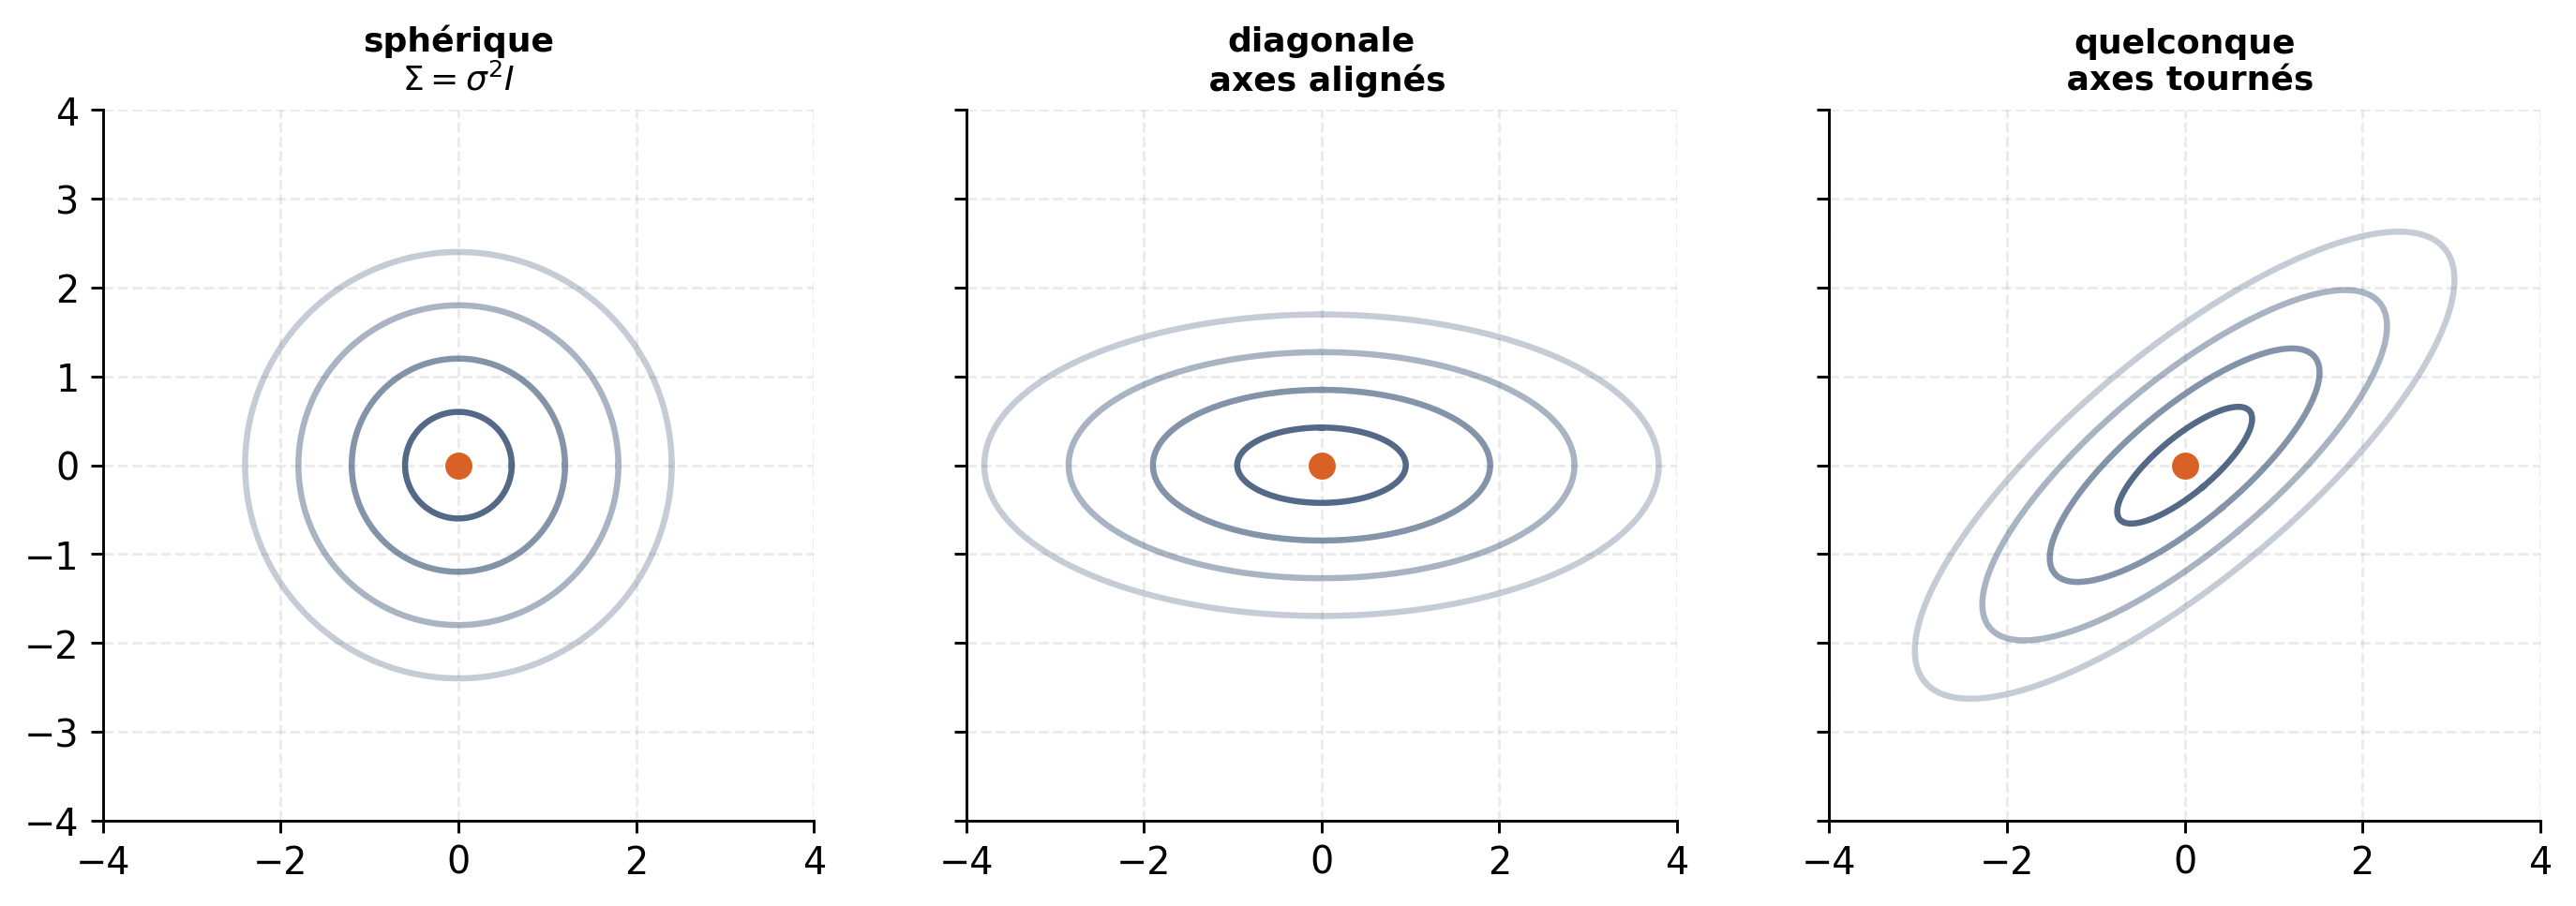
Trois contraintes sur \(\Sigma\), trois géométries. Le panneau du milieu est celui du Bayes naïf, celui de droite celui de LDA et QDA.
Lire une matrice de covariance
\[ \Sigma = \begin{pmatrix} \sigma_1^2 & \sigma_{12} \\ \sigma_{12} & \sigma_2^2 \end{pmatrix} \]
Diagonale : variances, étalement selon chaque axe.
Hors-diagonale : covariance, inclinaison des ellipses.
\(\sigma_{12} = 0\) : axes alignés sur les variables. Pour une gaussienne, décorrélation et indépendance coïncident.
Décomposition spectrale
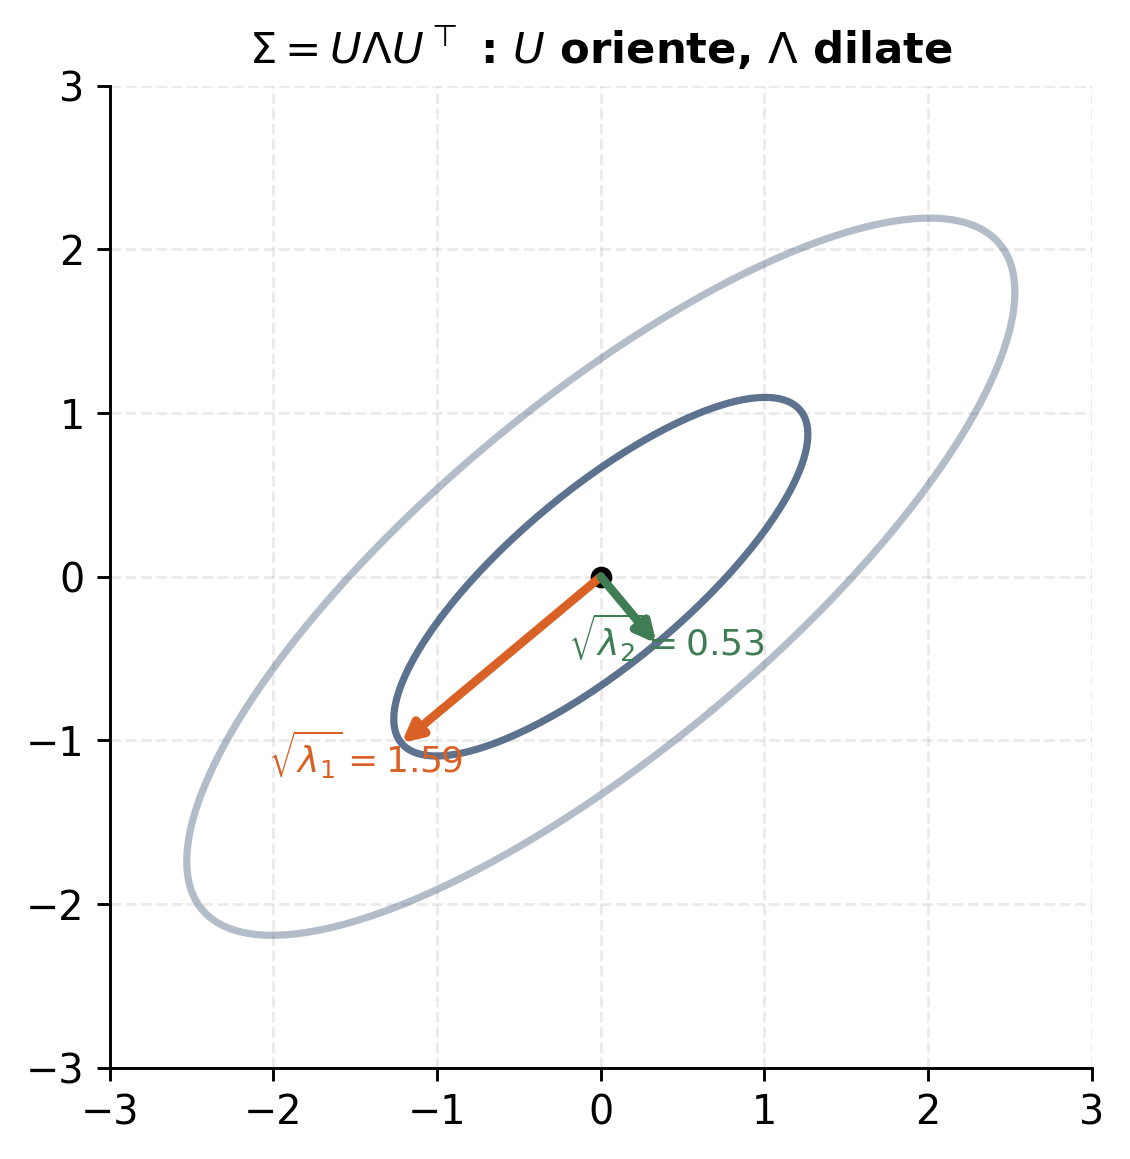
\(\Sigma = U \Lambda U^\top\). Vecteurs propres : directions. Racines des valeurs propres : longueurs. \(\det(\Sigma) = \prod_i \lambda_i\) : volume de l’ellipsoïde.
Trois nombres, trois rôles
En dimension 2, une covariance se lit :
- une orientation : l’angle de \(U\) ;
- deux allongements : \(\sqrt{\lambda_1}\) et \(\sqrt{\lambda_2}\).
Trois paramètres libres pour \(\Sigma\), contre deux pour \(\mu\).
En dimension \(d\) : \(d\) paramètres pour le centre, \(d(d+1)/2\) pour la covariance.
La distance de Mahalanobis
L’exposant de la densité est une distance :
\[ d_\Sigma^2(x, \mu) = (x - \mu)^\top \Sigma^{-1} (x - \mu) \]
Elle rapporte l’écart à la dispersion.
\(\Sigma = I\) redonne la distance euclidienne.
Euclide ne suffit pas
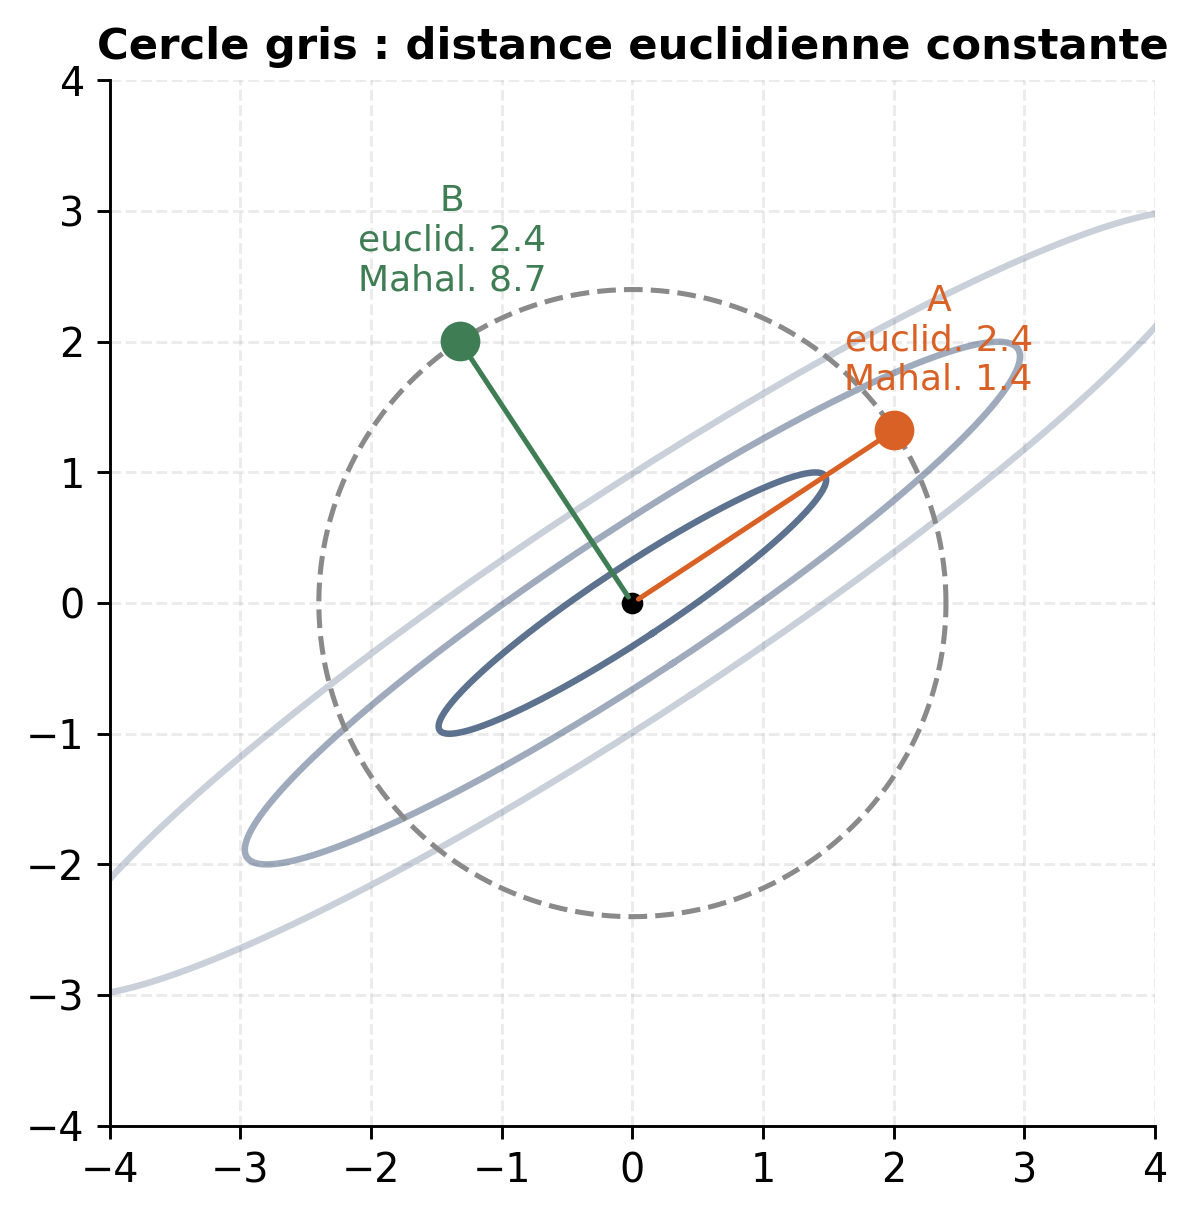
A et B sont à la même distance euclidienne du centre. B est nettement plus atypique.
Ce que la gaussienne fournit
Une densité dont le logarithme est une forme quadratique en \(x\) :
\[ \log f_k(x) = -\tfrac{1}{2} d_{\Sigma_k}^2(x, \mu_k) - \tfrac{1}{2} \log |\Sigma_k| - \tfrac{d}{2} \log 2\pi \]
Comparer deux classes revient à comparer deux formes quadratiques. La géométrie de la frontière en découle.
Bayes naïf, revisité
Ce qui a été vu
La séance précédente contournait le fléau de la dimension par une hypothèse :
Conditionnellement à la classe, les variables sont indépendantes.
\[ f_k(x) = \prod_{j=1}^d f_{kj}(x_j) \]
\(d\) densités unidimensionnelles au lieu d’une densité en dimension \(d\). Reste à voir où cette hypothèse se place dans la famille gaussienne.
L’hypothèse naïve, traduite en covariance
Si chaque \(f_{kj}\) est gaussienne, le produit est une gaussienne de covariance diagonale :
\[ \Sigma_k = \operatorname{diag}(\sigma_{k1}^2, \dots, \sigma_{kd}^2), \qquad |\Sigma_k| = \prod_{j=1}^d \sigma_{kj}^2. \]
Bayes naïf gaussien = une gaussienne par classe, aux axes alignés sur les variables. C’est le panneau du milieu de la première figure.
Aucune corrélation n’est modélisée — mais chaque classe garde ses propres étalements.
La fonction de décision
En reprenant \(\delta_k(x) = \log \pi_k + \log f_k(x)\) avec \(\Sigma_k\) diagonale :
\[ \delta_k(x) = \log \hat\pi_k - \sum_{j=1}^d \left[ \frac{(x_j - \hat\mu_{kj})^2}{2\,\hat\sigma_{kj}^2} + \log \hat\sigma_{kj} \right] \]
Le terme en \(x_j^2\) dépend de \(k\) par \(\hat\sigma_{kj}\) : il ne s’élimine pas.
Les frontières du Bayes naïf gaussien sont quadratiques, pas linéaires.
Sur une variable d’Iris
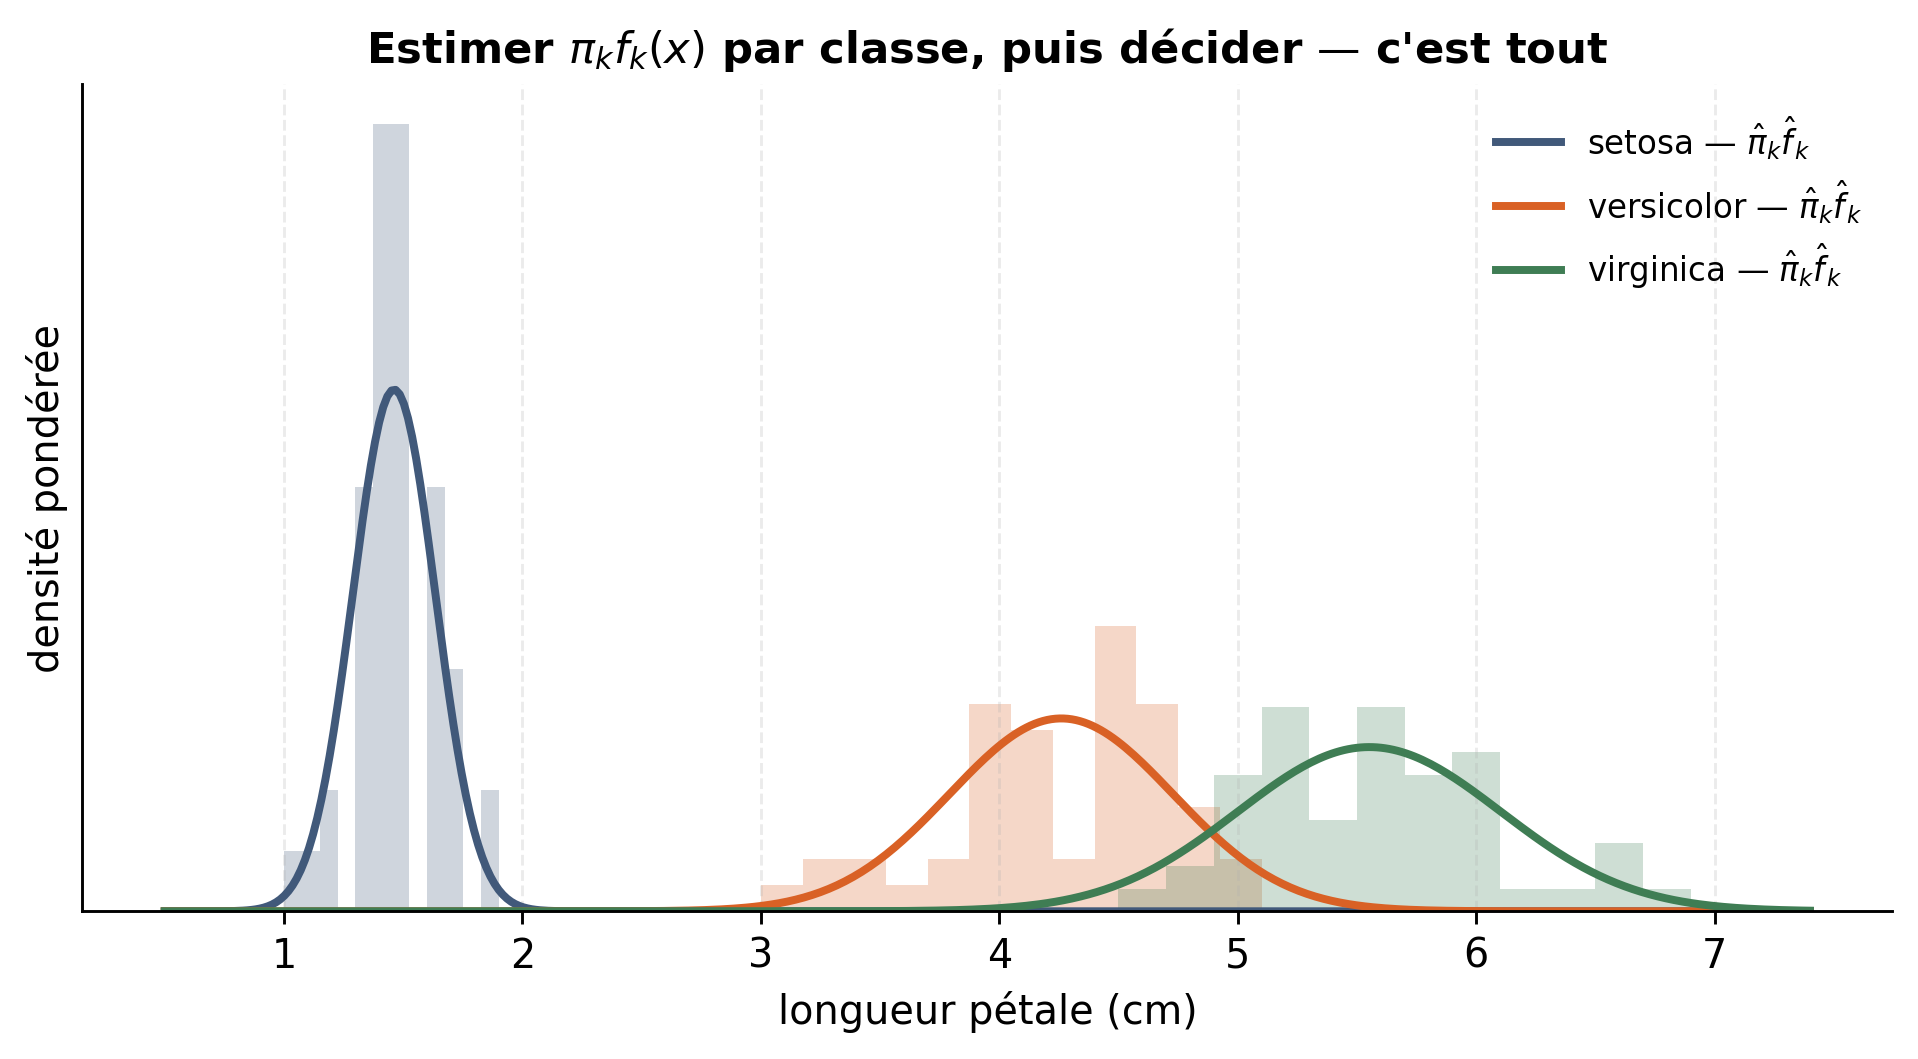
Une gaussienne ajustée par espèce, pondérée par \(\hat\pi_k\). En dimension \(d\), le modèle fait cela \(d\) fois, indépendamment.
Analyse discriminante linéaire
Le modèle
Une gaussienne par classe, de moyenne propre :
\[ X \mid Y = k \;\sim\; \mathcal N(\mu_k, \Sigma_k) \]
Hypothèse d’homoscédasticité
\[ \Sigma_k = \Sigma \quad \text{pour toute classe } k \]
Les classes diffèrent par leur position, pas par leur forme.
La règle de décision
Maximiser \(\pi_k f_k(x)\) équivaut à maximiser \(\log \pi_k + \log f_k(x)\) :
\[ \begin{aligned} \delta_k(x) &= \log \pi_k - \tfrac{1}{2}(x - \mu_k)^\top \Sigma^{-1} (x - \mu_k) \\ &= \log \pi_k - \tfrac{1}{2} x^\top \Sigma^{-1} x + x^\top \Sigma^{-1} \mu_k - \tfrac{1}{2} \mu_k^\top \Sigma^{-1} \mu_k \end{aligned} \]
Le terme \(x^\top \Sigma^{-1} x\) ne dépend pas de \(k\) : il disparaît de la comparaison. C’est là toute la différence avec le Bayes naïf.
Une fonction affine
\[ \delta_k(x) = \underbrace{x^\top \Sigma^{-1} \mu_k}_{\text{linéaire en } x} \underbrace{- \tfrac{1}{2} \mu_k^\top \Sigma^{-1} \mu_k + \log \pi_k}_{\text{constante}} \]
La frontière \(\delta_k(x) = \delta_\ell(x)\) est un hyperplan. Conséquence de l’homoscédasticité, pas une approximation.
Frontière explicite, cas binaire
\[ \delta_1(x) - \delta_0(x) = x^\top \underbrace{\Sigma^{-1}(\mu_1 - \mu_0)}_{w} + \underbrace{\log \frac{\pi_1}{\pi_0} - \tfrac{1}{2}(\mu_1 + \mu_0)^\top \Sigma^{-1}(\mu_1 - \mu_0)}_{b} \]
Décision : \(w^\top x + b > 0\).
Le vecteur \(w\) n’est pas \(\mu_1 - \mu_0\), mais cet écart corrigé par la covariance.
Lien avec Mahalanobis
Si \(\pi_0 = \pi_1\), la règle se réduit à :
\[ d_\Sigma^2(x, \mu_1) < d_\Sigma^2(x, \mu_0) \]
Affecter \(x\) à la classe au centre le plus proche — au sens de Mahalanobis, pas d’Euclide.
Des proportions déséquilibrées déplacent la frontière vers la classe rare : la même mécanique qu’au seuil \(t^*\) de la séance précédente.
Estimation
Trois quantités, toutes explicites :
\[ \hat\pi_k = \frac{n_k}{n}, \qquad \hat\mu_k = \frac{1}{n_k} \sum_{i : y_i = k} x_i \]
\[ \hat\Sigma = \frac{1}{n - K} \sum_{k} \sum_{i : y_i = k} (x_i - \hat\mu_k)(x_i - \hat\mu_k)^\top \]
La covariance est commune à toutes les classes. Chaque observation y contribue.
Analyse discriminante quadratique
Lever l’hypothèse
\[ X \mid Y = k \;\sim\; \mathcal N(\mu_k, \Sigma_k) \]
Une matrice de covariance par classe, sans contrainte de forme.
Le terme \(x^\top \Sigma_k^{-1} x\) dépend de \(k\). Il ne s’élimine plus — comme pour le Bayes naïf, mais cette fois les axes peuvent tourner.
Une fonction quadratique
\[ \delta_k(x) = \log \pi_k - \tfrac{1}{2} \log |\Sigma_k| - \tfrac{1}{2}(x - \mu_k)^\top \Sigma_k^{-1} (x - \mu_k) \]
La frontière est une conique : ellipse, parabole ou hyperbole selon les covariances.
Le terme \(\log |\Sigma_k|\) pénalise les classes très dispersées.
Les deux modèles, côte à côte
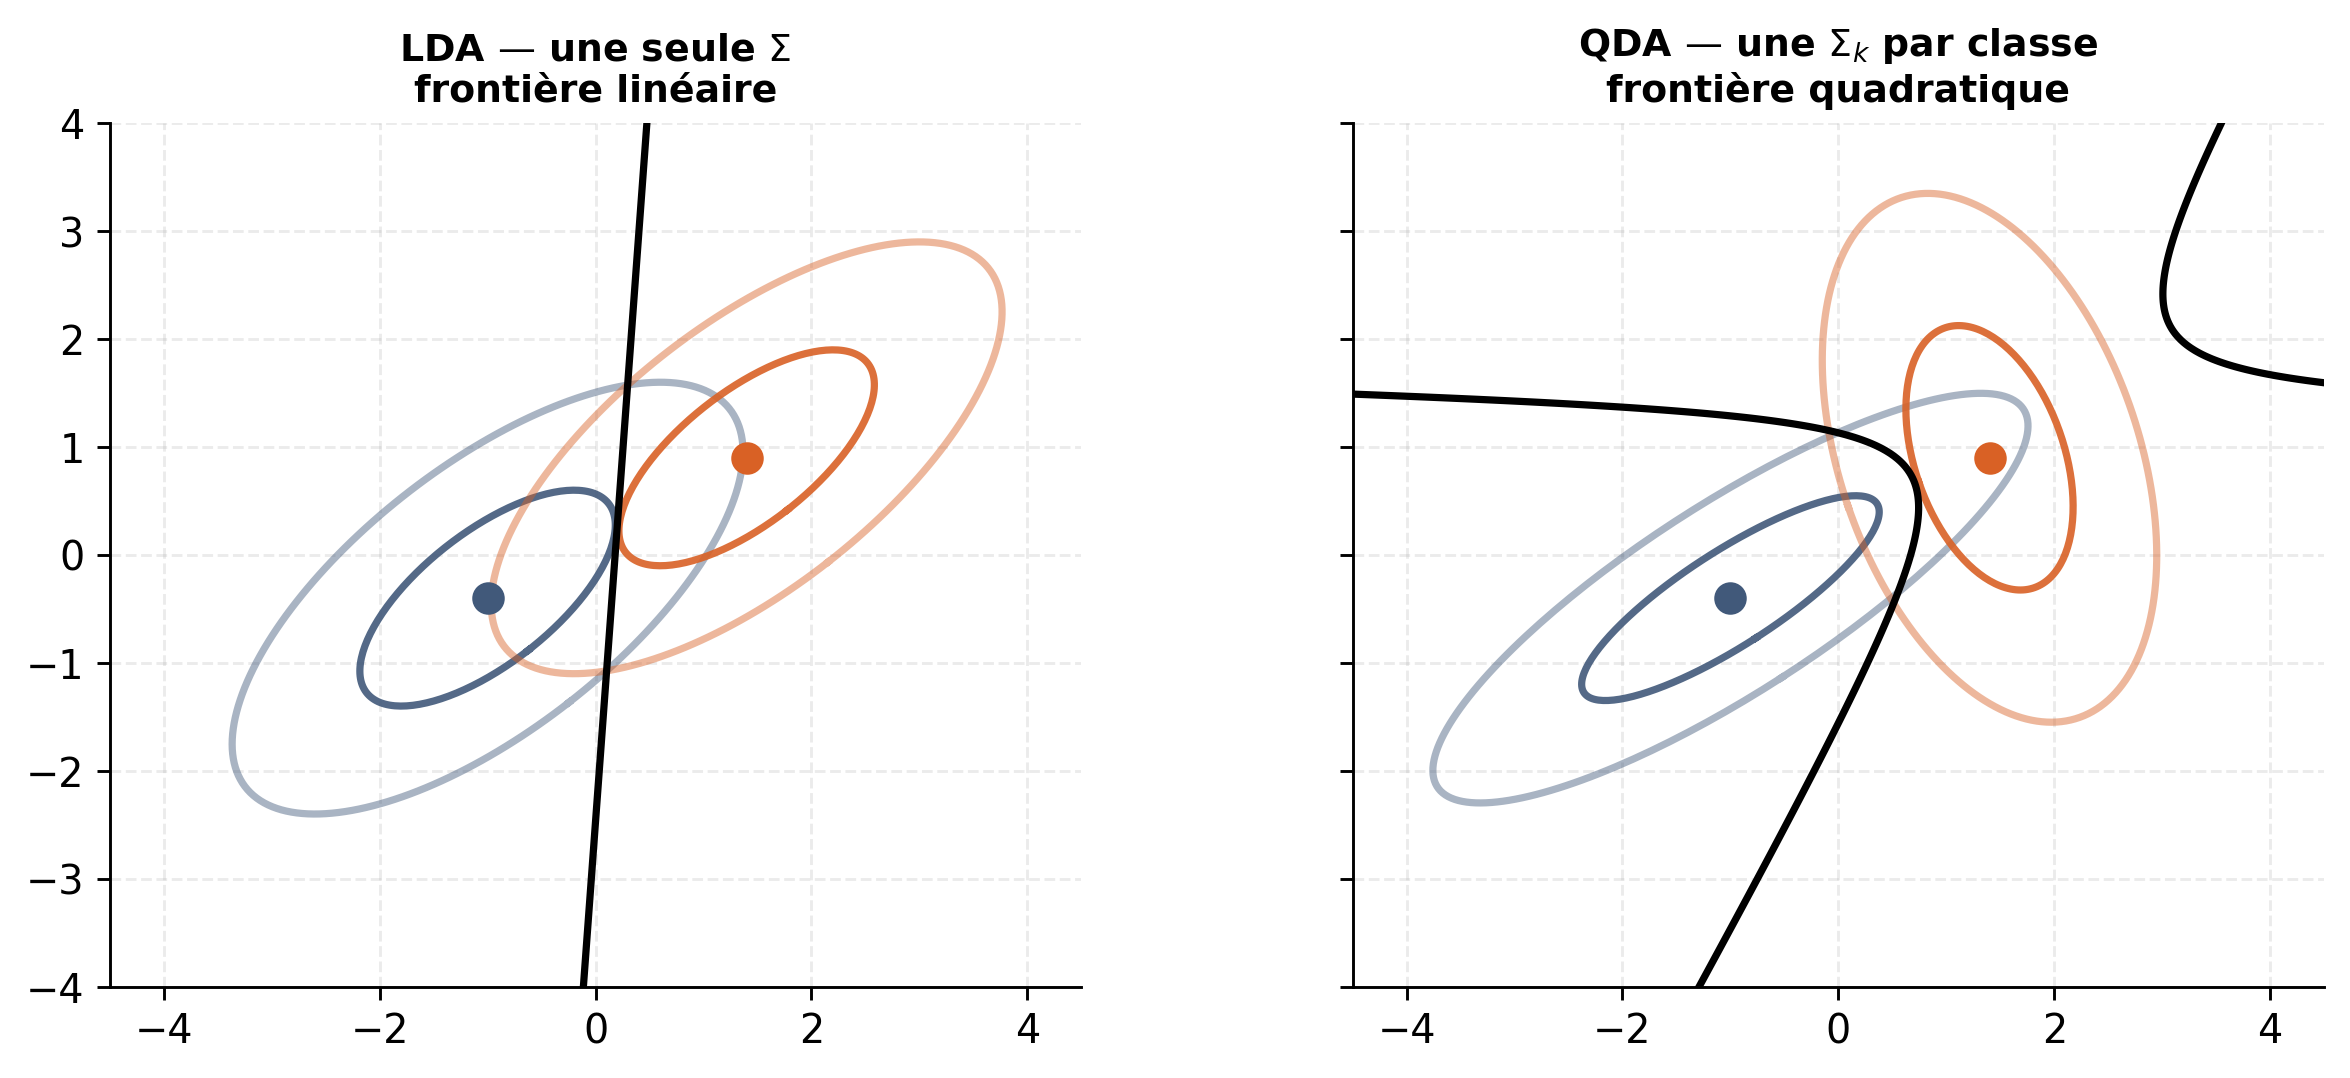
À gauche : ellipses identiques à translation près. À droite : chacune a sa forme.
Sur Iris
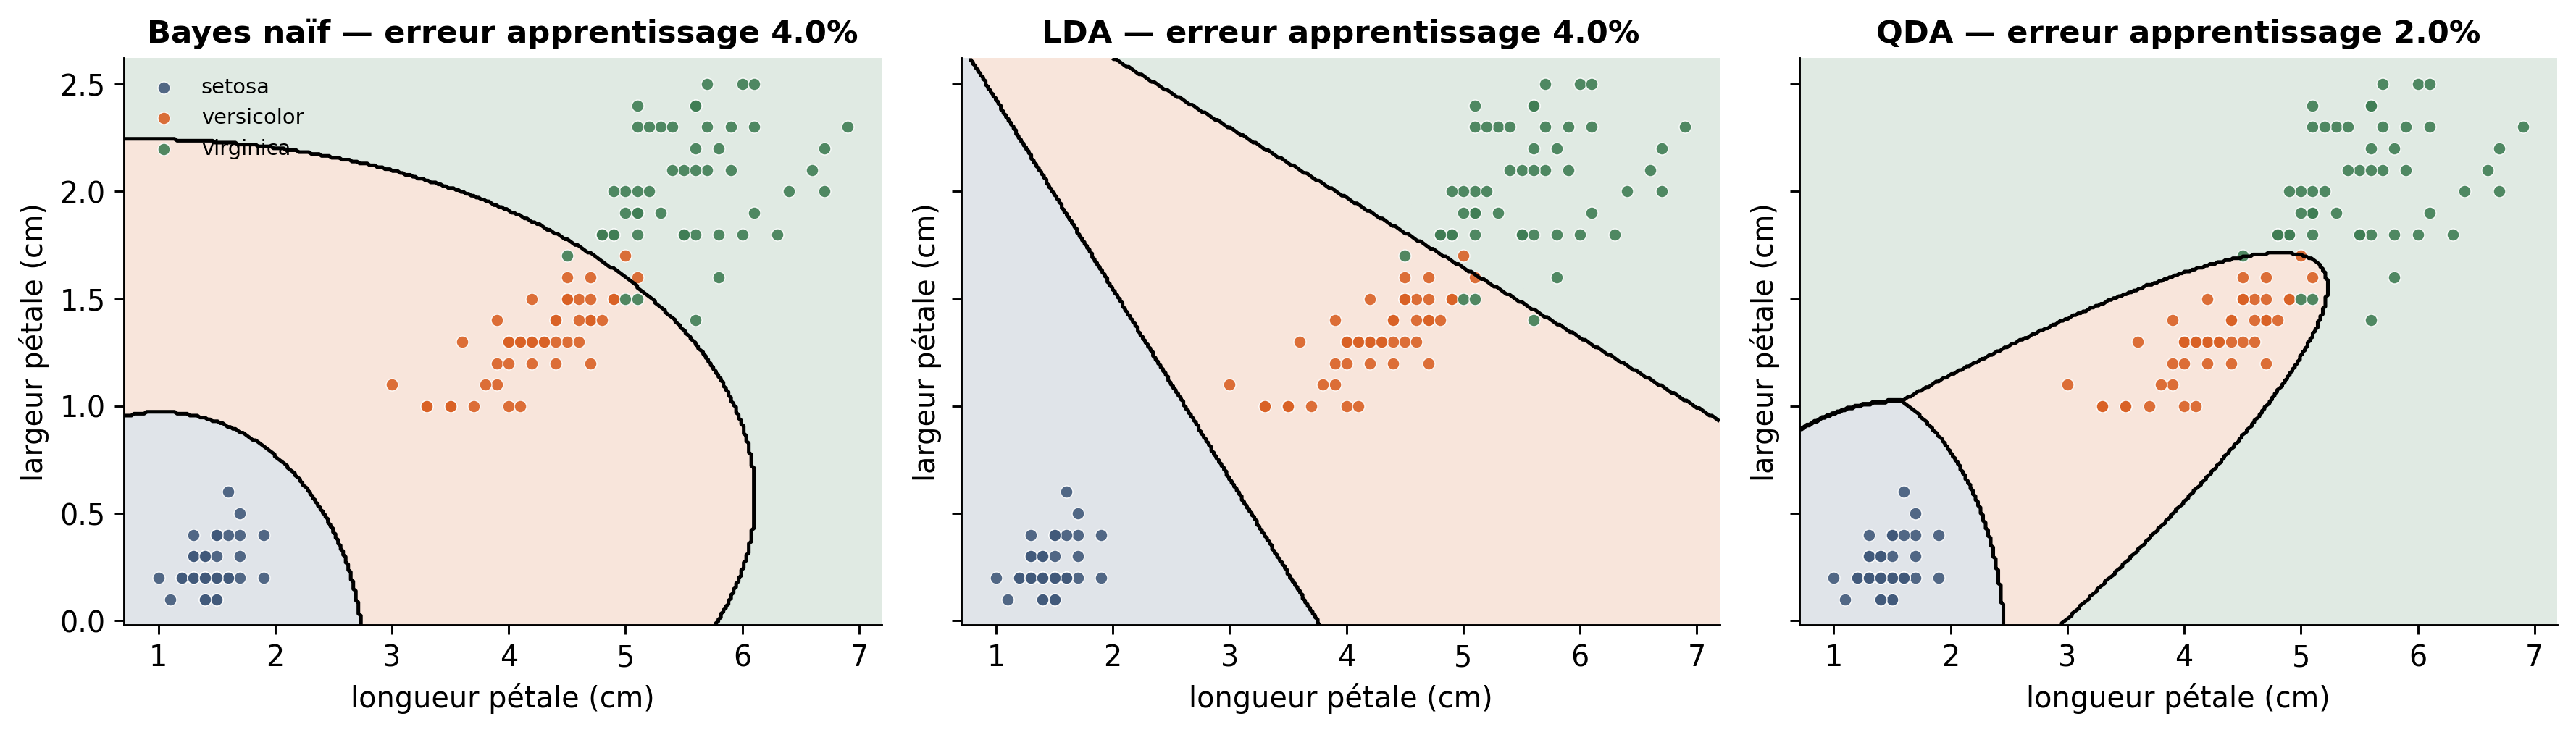
Frontières droites pour LDA, courbes pour les deux autres.
Ce que la figure montre
Sur les deux mesures de pétale, en validation croisée à dix plis :
| Modèle | Erreur d’apprentissage | Erreur validée |
|---|---|---|
| Bayes naïf | 4,0 % | 4,0 % |
| LDA | 4,0 % | 4,0 % |
| QDA | 2,0 % | 2,7 % |
QDA gagne ici : les trois espèces n’ont visiblement pas la même dispersion.
Sur les quatre variables, LDA passe à 2,0 % et rejoint QDA, tandis que Bayes naïf reste à 4,7 %. Le classement dépend des variables retenues.
En scikit-learn
from sklearn.naive_bayes import GaussianNB
from sklearn.discriminant_analysis import (
    LinearDiscriminantAnalysis, QuadraticDiscriminantAnalysis)

nb  = GaussianNB().fit(X, y)
lda = LinearDiscriminantAnalysis(store_covariance=True).fit(X, y)
qda = QuadraticDiscriminantAnalysis(store_covariance=True).fit(X, y)

nb.var_           # les sigma_kj^2, une ligne par classe
lda.covariance_   # la Sigma commune
qda.covariance_   # la liste des Sigma_k
store_covariance=True conserve les matrices estimées. Sans lui, elles sont calculées puis jetées.
Le coût de la richesse
Compter les paramètres
Pour \(K\) classes en dimension \(d\) :
| Modèle | Covariance | Paramètres de covariance |
|---|---|---|
| Sphérique | \(\sigma_k^2 I\) | \(K\) |
| Bayes naïf | \(\Sigma_k\) diagonale | \(K d\) |
| LDA | \(\Sigma\) commune | \(d(d+1)/2\) |
| QDA | \(\Sigma_k\) pleine | \(K \, d(d+1)/2\) |
Croissance quadratique en \(d\) pour les deux derniers.
L’explosion
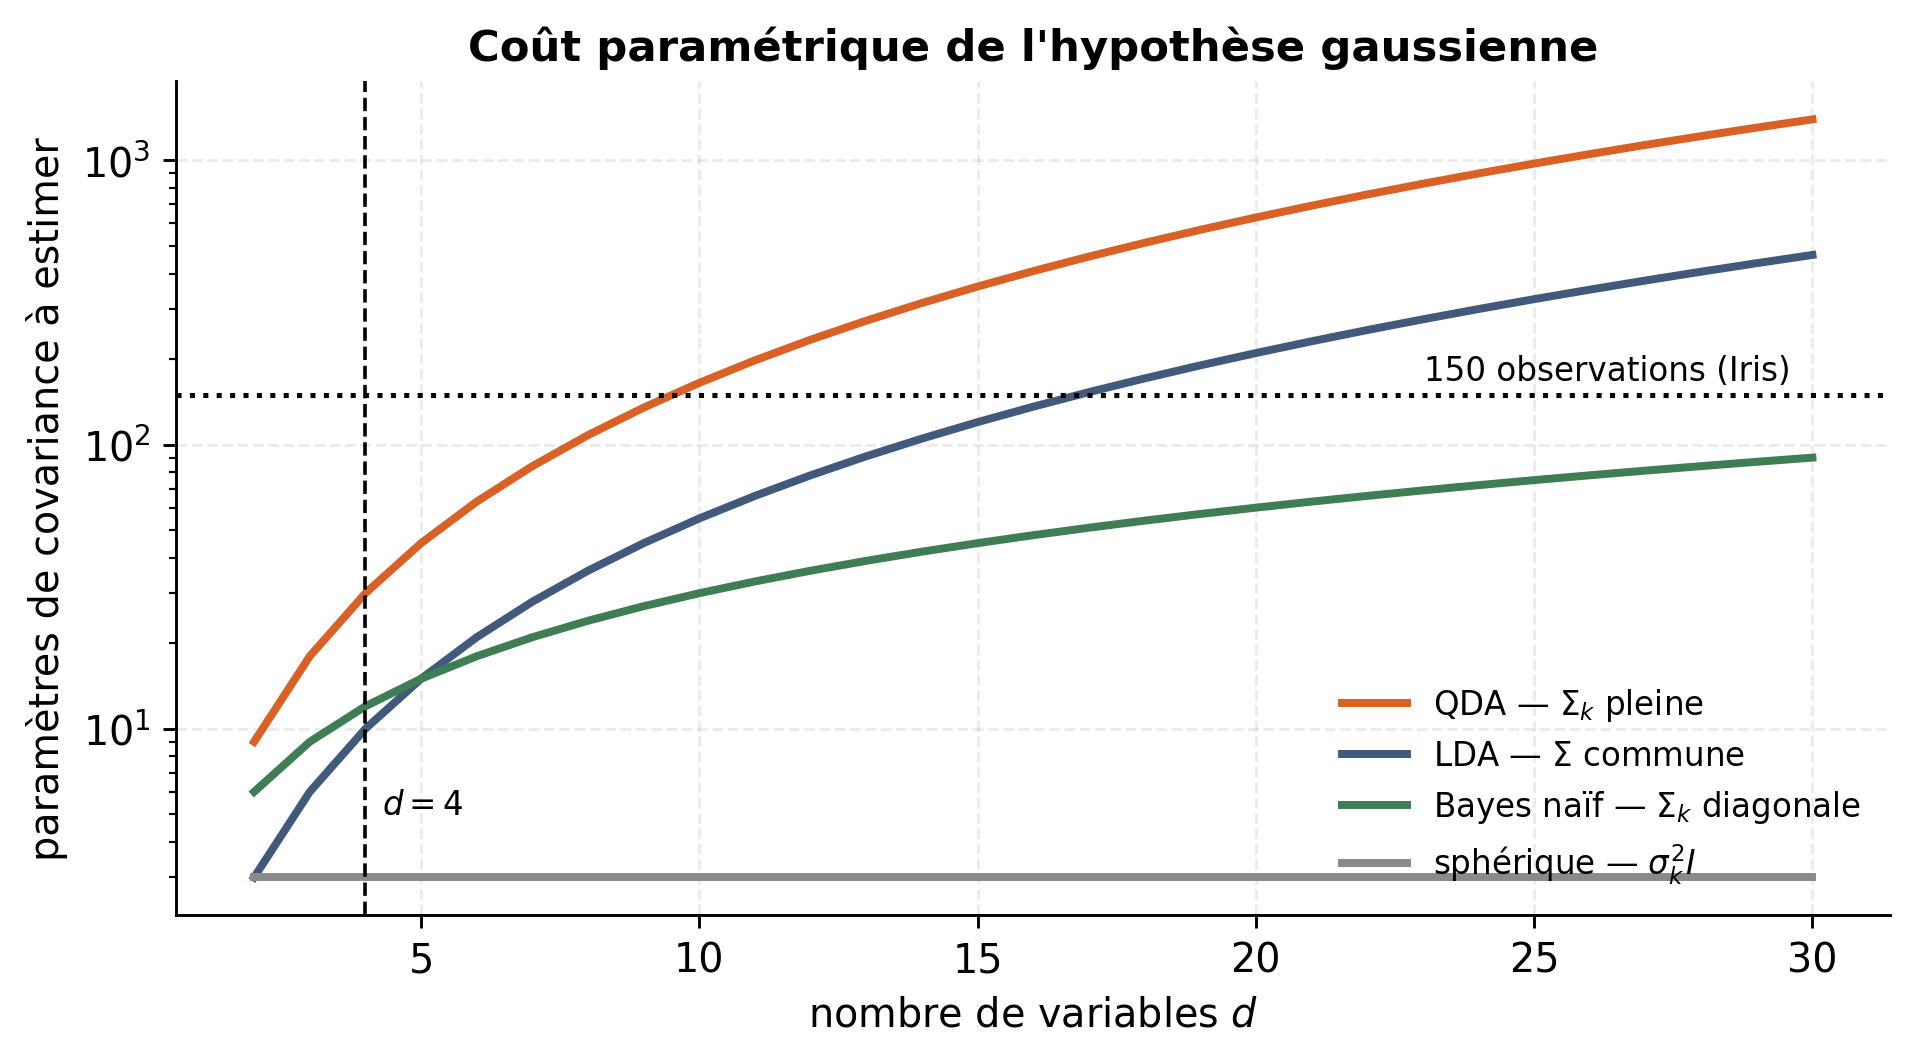
Échelle logarithmique. La ligne pointillée marque les 150 observations d’Iris.
Un exemple chiffré
Sur Iris, \(d = 4\) variables et \(K = 3\) classes :
| Covariance | Total avec \(\mu_k\) et \(\pi_k\) | |
|---|---|---|
| Bayes naïf | 12 | 26 |
| LDA | 10 | 24 |
| QDA | 30 | 44 |
QDA estime 30 paramètres de covariance sur 150 observations, soit 10 par classe pour 50 fleurs. La marge est courte.
Le compromis, en clair
Plus de paramètres : moins de biais, plus de variance. Le dilemme de la séance précédente, transposé au choix de modèle.
QDA gagne toujours sur l’erreur d’apprentissage : strictement plus de liberté.
QDA perd souvent sur l’erreur de test : matrices mal estimées.
Modèles parcimonieux
Contraindre \(\Sigma_k\) sans l’imposer identique :
- Diagonale : variables indépendantes par classe. Exactement le Bayes naïf gaussien.
- Sphérique : une seule variance par classe. Frontières circulaires.
- Régularisée : \(\hat\Sigma_k^{(\alpha)} = \alpha \hat\Sigma_k + (1 - \alpha) \hat\Sigma\), interpolation continue entre QDA et LDA.
\(\alpha\) se choisit par validation croisée.
Bayes naïf, LDA, QDA
Trois points d’une même famille. Seule la contrainte sur \(\Sigma\) change.
| Corrélations | Formes par classe | Frontière | |
|---|---|---|---|
| Bayes naïf | ignorées | oui | quadratique |
| LDA | modélisées | non | linéaire |
| QDA | modélisées | oui | quadratique |
Aucun n’est meilleur dans l’absolu. Le choix dépend de \(n\), de \(d\) et de la géométrie réelle des classes.
Un modèle faux, mais utile
L’indépendance conditionnelle est fausse sur Iris : au sein de versicolor, longueur et largeur de pétale sont corrélées à 0,79.
Bayes naïf s’en tire pourtant à 4 % d’erreur. Pour classer, il suffit que la bonne classe arrive en tête ; les probabilités estimées peuvent être mauvaises sans que la décision le soit.
Un modèle faux peut être utile. C’est même le cas général.
Remarques
Une variable qualitative n’a pas de densité gaussienne : la traiter comme telle n’a pas de sens.
Une variable très asymétrique respecte mal l’hypothèse. Une transformation logarithmique aide souvent.
Le choix du modèle contraint les données admissibles. L’inverse est aussi vrai.
Synthèse
- La gaussienne réduit une densité à un centre et une géométrie.
- La distance de Mahalanobis rapporte l’écart à la dispersion.
- Bayes naïf, c’est \(\Sigma_k\) diagonale : pas de corrélations, mais une forme par classe, donc des frontières quadratiques.
- Covariance commune : frontière linéaire. Covariance par classe et pleine : frontière quadratique.
- Le coût paramétrique croît en \(d^2\) ; le choix se tranche sur des données jamais vues.